Für eine kleine Firmenwebsite reicht meist die Search Console. Ein Shop ist anders gebaut: Jede Kategorie lässt sich filtern und sortieren, Produkte haben Varianten, kommen dazu, sind ausverkauft oder verschwinden. Dazu holen Shopping-Crawler und KI-Bots Produktseiten ab. Was davon in deinem Shop wirklich passiert, steht in den Zugriffslogs.
Wie eine Logzeile aufgebaut ist, wie du echte Bots von gefälschten trennst und was der Datenschutz verlangt, erkläre ich im Ratgeber Logfile-Analyse für SEO. Hier geht es um das, was nur Shops betrifft.
Warum Shops anders gecrawlt werden als Websites
Google beschreibt drei Gruppen von Websites, für die das Crawling-Budget zählt: über eine Million einzelne Seiten mit wöchentlichen Änderungen, über 10.000 mit täglichen Änderungen, oder ein großer Teil der Adressen steht in der Search Console unter „Gefunden – zurzeit nicht indexiert“. Google nennt das ausdrücklich grobe Werte, keine festen Schwellen (Crawling-Budget-Leitfaden, Stand 16.09.2026). Shops treffen diese Gruppen auf eigene Weise:
- Filter und Sortierung. Facettennavigation kann laut Google unendlich viele Adressen erzeugen. Crawler rufen dann viele davon ab, bevor klar ist, dass sie nutzlos sind, und haben weniger Zeit für neue, nützliche Seiten (Google: Facettennavigation, Stand 06.03.2026). Laut Search Engine Land nannte Gary Illyes im Podcast „Search Off the Record“ vom 3. Februar 2026 Facetten als Ursache von rund der Hälfte der Crawling-Probleme aus Googles Jahresrückblick 2025, Aktions-Parameter von rund einem Viertel.
- Mehrere Google-Crawler, eine Kapazität. Googlebot, AdsBot und der Shopping-Crawler haben jeweils eigenen Bedarf, teilen sich aber die Crawl-Kapazität deines Servers. Für Produkte in deinen Merchant-Center-Feeds hat Google Shopping laut Google einen höheren Bedarf (Crawling-Budget-Leitfaden).
- Ein Sortiment in Bewegung. Produkte kommen dazu, sind ausverkauft, werden gelöscht oder ersetzt. Ob tägliche Preis- und Bestandsänderungen für Google als „täglich geänderter Inhalt“ zählen, dokumentiert Google nicht.
- KI-Bots. Die Crawling-Statistik der Search Console zeigt nur Google-Crawler. Google Analytics schließt bekannte Bots automatisch aus und zeigt nicht, wie viele (Analytics-Hilfe). Abrufe von GPTBot, ChatGPT-User, ClaudeBot oder PerplexityBot siehst du nur in Server- oder CDN-Logs.
Google zählt in „einzelnen Seiten“. Ob Filterkopien dazugehören, ist Auslegung. Sicher ist: Filter, Sortierung und Varianten machen aus einer Kategorie viele abrufbare Adressen. Wie schnell das wächst, rechnet der Facetten-Rechner auf der Seite Technisches SEO vor. Wie viele davon der Googlebot tatsächlich abruft, zeigt erst das Log.
Logzugang je Shopsystem: wo deine Logs liegen
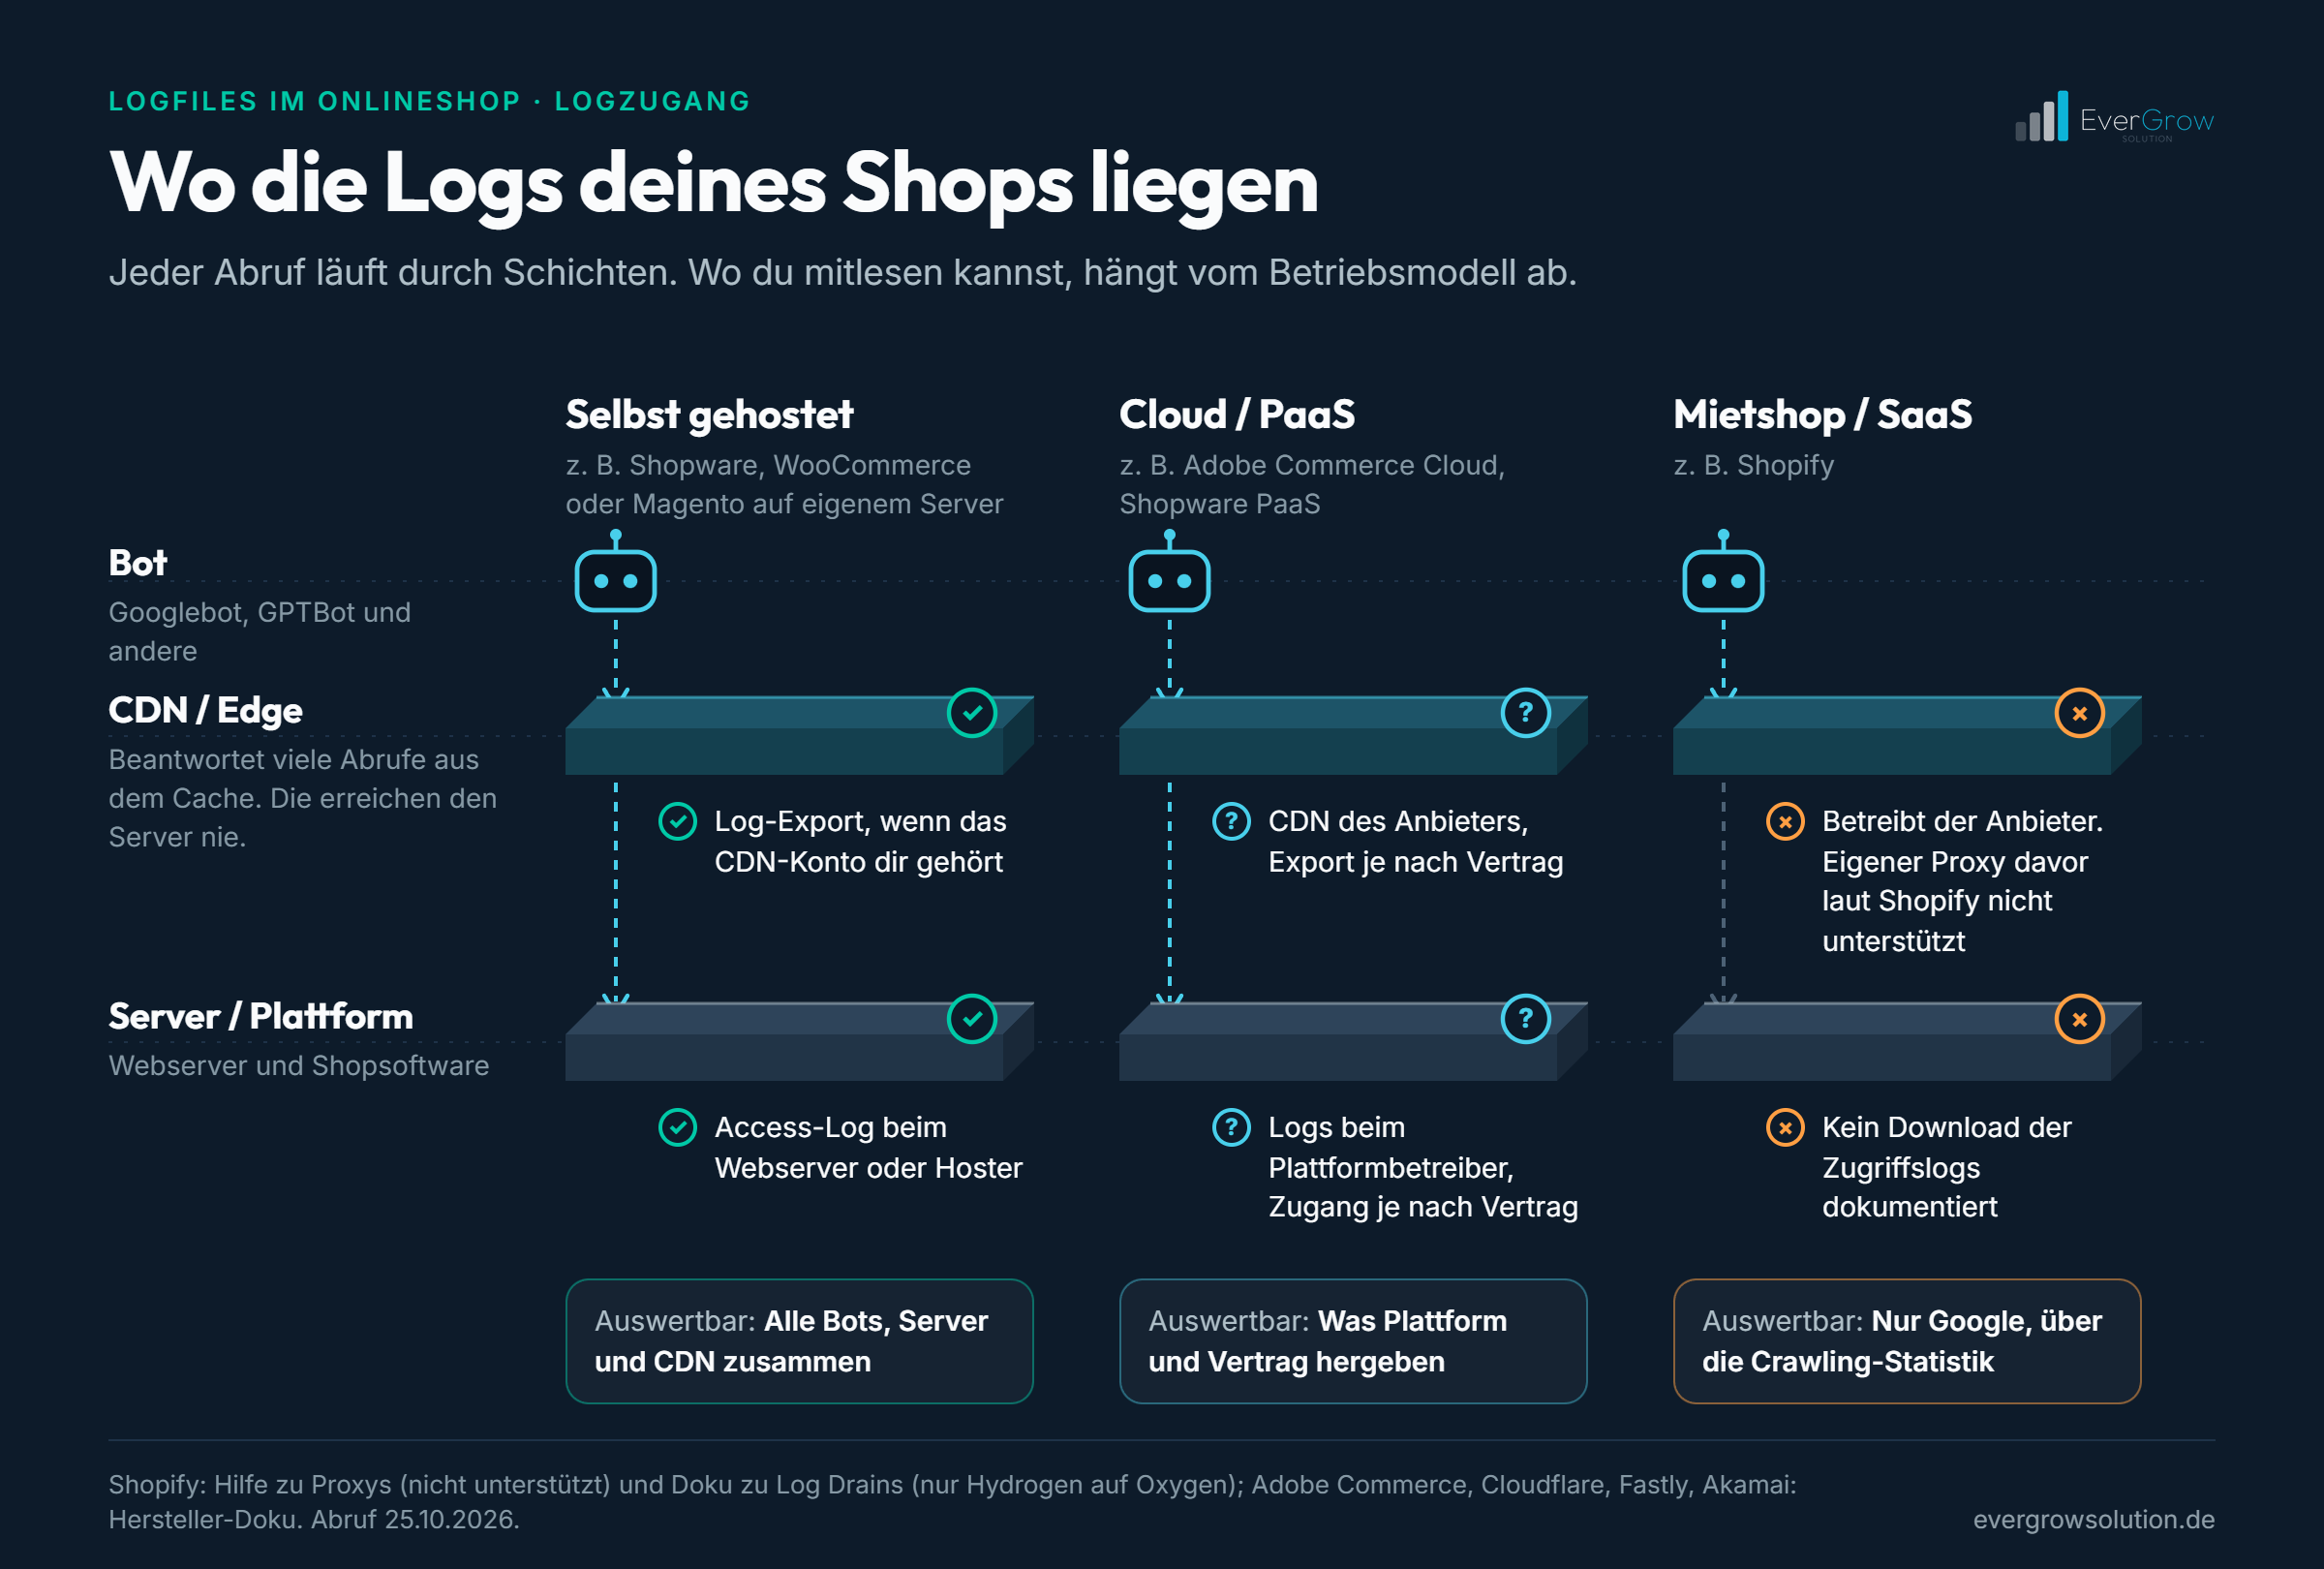
Für die Analyse brauchst du die Zugriffslogs: eine Zeile je Abruf, mit IP, Zeit, Adresse, Statuscode und User-Agent. Die stehen nicht im Shop-Backend. Was Shopware, WooCommerce oder JTL dort „Log“ nennen, sind Fehler- und Ereignisprotokolle. Wo die Zugriffslogs liegen und ob du sie bekommst, hängt am Shopsystem und daran, wer es betreibt.
| Shopsystem und Betrieb | Wo die Zugriffslogs liegen | Worauf du achtest |
|---|---|---|
| Shopify, Shopify Plus (Theme-Shop) | Kein dokumentierter Zugang: In Shopifys Doku findet sich kein Weg, die Zugriffslogs des Online-Shops herunterzuladen. Log Drains gibt es nur für Hydrogen auf Oxygen (nächste Zeile). | Ein vorgeschalteter CDN-Proxy, auch Cloudflare O2O, wird laut Shopify-Hilfe nicht unterstützt. Für Google bleibt die Crawling-Statistik. |
| Shopify headless (Hydrogen auf Oxygen) | Log Drains an Splunk, Datadog oder New Relic, nur mit Shopify Plus (shopify.dev). | Die Request-Logs enthalten laut Doku Pfad, Statuscode und User-Agent, ein Feld für die Client-IP nennt sie nicht. Ohne IP prüfst du keinen Bot gegen die Liste seines Betreibers. |
| Shopware, selbst gehostet | Beim Webserver bzw. beim Hoster: Hosting-Panel, SFTP oder SSH. | Die Shopware-Dateien in var/log sind Fehlerprotokolle. Wo die Zugriffslogs liegen, sagt dir laut Shopware-Doku dein Hoster. |
| Shopware SaaS und PaaS | Shopware betreibt die Infrastruktur (Verantwortlichkeiten); PaaS Native liefert eigene Domains über das CDN Fastly aus (PaaS-Doku). | Einen Export der Zugriffslogs sichert die öffentliche Doku nicht zu. Frag nach Ursprungs- und CDN-Logs, Feldern und Aufbewahrung. |
| WooCommerce (WordPress) | Beim Hoster, nicht in WooCommerce. | Unter WooCommerce › Status › Protokolle stehen Ereignis- und Fehlerprotokolle (WooCommerce-Doku). Abrufe, die ein Seiten-Cache oder CDN beantwortet, sieht ein Plugin nicht. |
| Magento Open Source, Adobe Commerce selbst gehostet | Am Webserver, am Load Balancer und gegebenenfalls am CDN. | Bei mehreren Servern liegen die Logs verteilt. Hol alle Quellen für denselben Zeitraum und rechne sie auf eine Zeitzone um. |
| Adobe Commerce on cloud | Über magento-cloud log access oder per SSH in /var/log/access.log (Adobe-Doku). | In Pro-Umgebungen liegen Fastly- und WAF-Logs in New Relic (Adobe: Fastly). Ursprung und CDN getrennt holen. |
| JTL-Shop | Beim Hosting. Frag dort nach den Zugriffslogs. | Das JTL-Logbuch führt Fehler, Warnungen, Hinweise und Debug-Meldungen (JTL-Guide). Abrufe von Besuchern und Bots nennt die Doku dort nicht. |
| Headless allgemein (Shop-Backend als Dienst, eigenes Frontend) | Am Frontend-Hosting oder am CDN, nicht im Backend. | API-Logs des Backends zeigen keine Bot-Abrufe deiner HTML-Seiten. Maßgeblich ist, wer die Storefront ausliefert. |
| Andere Mietshops | Beim Anbieter. | Frag nach einem Export der Zugriffslogs. Gibt es keinen, gilt dasselbe wie bei Shopify: siehe Notlösungen unten. |
Stand 25.10.2026, Grundlage ist die öffentliche Dokumentation der Anbieter. Ob dein Vertrag mehr oder weniger erlaubt, klärst du beim Anbieter.
Wenn ein CDN vor deinem Shop steht
Steht Cloudflare, Akamai oder Fastly vor dem Shop, beantwortet das CDN viele Abrufe aus dem Zwischenspeicher. Der Shopserver sieht sie nie. Dann sind die CDN-Logs die vollständigere Quelle:
- Cloudflare Logpush gibt es auf Free, Pro und Business als nutzungsabhängig berechneten Dienst. Daten gibt es erst ab der Einrichtung, rückwirkend nicht (Cloudflare-Doku, Stand 22.10.2026).
- Akamai DataStream 2 schickt Logs an ein Ziel deiner Wahl; Felder und Stichprobenrate legst du selbst fest (Akamai-Doku). Fehlen User-Agent oder Client-IP, oder läuft nur eine Stichprobe, taugt der Stream kaum für SEO.
- Fastly streamt Logs in Echtzeit an ein Ziel deiner Wahl, laut Fastly ohne Zustellgarantie (Fastly-Doku).
Mein Rat: Richte den Export ein, bevor du ihn brauchst. Nach einem Relaunch oder einem Einbruch willst du die Wochen davor sehen, und die gibt es nur, wenn sie aufgezeichnet wurden.
Ohne Rohlogs: drei Notlösungen und ihre Grenzen
CDN vor dem Shop, mit eigener Zone
Bringt: Alle Abrufe, die über deine Zone laufen, auch die der KI-Bots, mit IP und User-Agent.
Grenze: Du brauchst die Verwaltung der Zone. Bei Shopify ist ein vorgeschalteter Proxy laut Shopify nicht unterstützt, auch nicht Cloudflare O2O. Cloudflare dokumentiert den Weg zwar, bei Problemen hilft der Shopify-Support aber nicht.
Edge-Erfassung, zum Beispiel per Cloudflare Worker
Bringt: Ein kleines Programm am CDN schreibt Abrufe selbst mit, auch auf kleinen Tarifen.
Grenze: Sichtbar ist nur, was über die erfassten Pfade läuft. Worker, Speicher und Versand kosten extra. Beim Cloudflare-Weg für Shopify sind Workers auf /checkout abgeschaltet, und die Supportgrenze von Shopify gilt auch hier.
Crawling-Statistik und URL-Prüfung der Search Console
Bringt: Anfragen, Antworten, Ladezeiten, Crawler-Typen und Beispiel-URLs von Google; für einzelne Adressen das Datum des letzten Crawls.
Grenze: Nur Google-Crawler, nur für Properties auf oberster Ebene. Die Beispiel-URLs sind laut Google nicht vollständig, Zahlen können leicht von Server-Logs abweichen. Keine KI-Bots, kein Verlauf je Adresse.
Quellen: Shopify-Hilfe zu Proxys, Cloudflare zu O2O für Shopify, Search-Console-Hilfe zur Crawling-Statistik.
Filter und Sortierung: wohin der Googlebot seine Abrufe trägt
Das häufigste Shop-Muster im Log: Der Googlebot ruft Kategorie-Adressen mit Filter- und Sortierparametern ab, oft viel häufiger als Produktseiten. So sieht das aus:
# Eine Kategorie, zehn Minuten, nur geprüfte Googlebot-Abrufe.
# Gekürzt auf Uhrzeit, Anfrage und Statuscode.
03:12:41  GET  /damen/sneaker/                                   200
03:12:58  GET  /damen/sneaker/?farbe=weiss                       200
03:13:20  GET  /damen/sneaker/?groesse=39&farbe=weiss            200
03:13:44  GET  /damen/sneaker/?farbe=weiss&groesse=39            200  ← dieselbe Auswahl, andere Reihenfolge
03:14:05  GET  /damen/sneaker/?farbe=lila&groesse=46&sort=preis  200  ← keine Treffer, trotzdem 200
03:14:31  GET  /warenkorb/?add=48213                             302  ← Warenkorb-Link
03:15:02  GET  /p/sneaker-weiss-48213/                           200  ← das einzige Produkt
Was Google dazu empfiehlt
- Nicht gewollte Filteradressen per robots.txt vom Crawl ausschließen.
rel="canonical"undrel="nofollow"wirken laut Google auf lange Sicht schwächer als die Sperre. - Sollen Filter gecrawlt werden:
&als Trenner, feste Reihenfolge der Filter, keine doppelten Filter und 404 für Kombinationen ohne Treffer (Google: Facettennavigation). - noindex spart keine Abrufe. Google fordert die Seite trotzdem an und verwirft sie erst danach (Crawling-Budget-Leitfaden).
Prüffragen für dein Log
- Welcher Teil der geprüften Googlebot-Abrufe geht auf Adressen mit Parametern, welcher auf Produkte und Kategorien? Und wie verändert sich das von Woche zu Woche?
- Welche Parameter tauchen auf, die dein Shop gar nicht mehr verlinkt, etwa aus alten Kampagnen oder einem früheren Shopsystem?
- Ruft der Bot die gesperrten Muster nach einer robots.txt-Änderung wirklich nicht mehr ab, und steigen dafür die Abrufe auf Produkte?
Bei Shopware heißen die Parameter unter anderem order, p und properties; wie du sie regelst, steht im Ratgeber Shopware SEO. Bei Shopify sind es vor allem Tag-Filter und ?sort_by=.
Varianten und Paginierung: einzeln abgerufen oder nie erreicht
Wie Varianten im Log auftauchen, hängt davon ab, wie dein Shop sie adressiert. Google beschreibt zwei Wege: alle Varianten auf einer Seite, wobei jede Variante über einen eigenen Parameter direkt vorausgewählt werden kann, oder die Varianten auf mehrere Seiten verteilt, etwa eine Seite je Farbe. Beim ersten Weg soll es genau eine kanonische Adresse für die ganze Produktgruppe geben. Eine eigene, direkt aufrufbare Adresse je Variante erlaubt Google, jede Variante zu crawlen und zu erkennen (Google: Produktvarianten, Stand 12.09.2026).
Im Log beantwortest du damit zwei Fragen: Ruft der Googlebot jede Variante einzeln ab, und gehen dafür Abrufe verloren, die anderen Produkten fehlen? Und andersherum: Bekommt die Hauptadresse genug Abrufe, oder verteilt sich alles auf die Varianten?
# Vier Wochen, nur geprüfte Googlebot-Abrufe, gezählt je Adresse.
/p/trailjacke/                       3 Abrufe
/p/trailjacke/?variant=4711          2 Abrufe   ← Größe S
/p/trailjacke/?variant=4712          2 Abrufe   ← Größe M
/p/trailjacke/?variant=4713          1 Abruf    ← Größe L
/herren/jacken/                      41 Abrufe
/herren/jacken/?page=2               9 Abrufe
/herren/jacken/?page=3               2 Abrufe
/herren/jacken/?page=4 bis ?page=19  0 Abrufe   ← Produkte nur dort verlinkt
Für Kategorien mit mehreren Seiten empfiehlt Google eine eigene Adresse je Seite, zum Beispiel ?page=2, Links von Seite zu Seite als normale <a href>-Links und nicht Seite 1 als Canonical für alle Seiten. Inhalte hinter „Mehr laden“ oder unendlichem Scrollen erreicht Google nur, wenn sie zusätzlich verlinkt sind: Googles Crawler klicken keine Schaltflächen (Google: Paginierung, Stand 18.12.2025).
Im Log siehst du, wie tief der Bot in die Seiten einer Kategorie geht. Produkte, die nur auf den hinteren Seiten verlinkt sind, bekommen dann selten oder nie einen Abruf. Das ist eine mögliche Erklärung, wenn Produkte lange unter „Gefunden – zurzeit nicht indexiert“ stehen.
Neue Produkte: Zeit bis zum ersten Abruf
Die nächsten zwei Abschnitte folgen einem Produkt durch sein Leben im Log: vom ersten Abruf bis zum letzten.
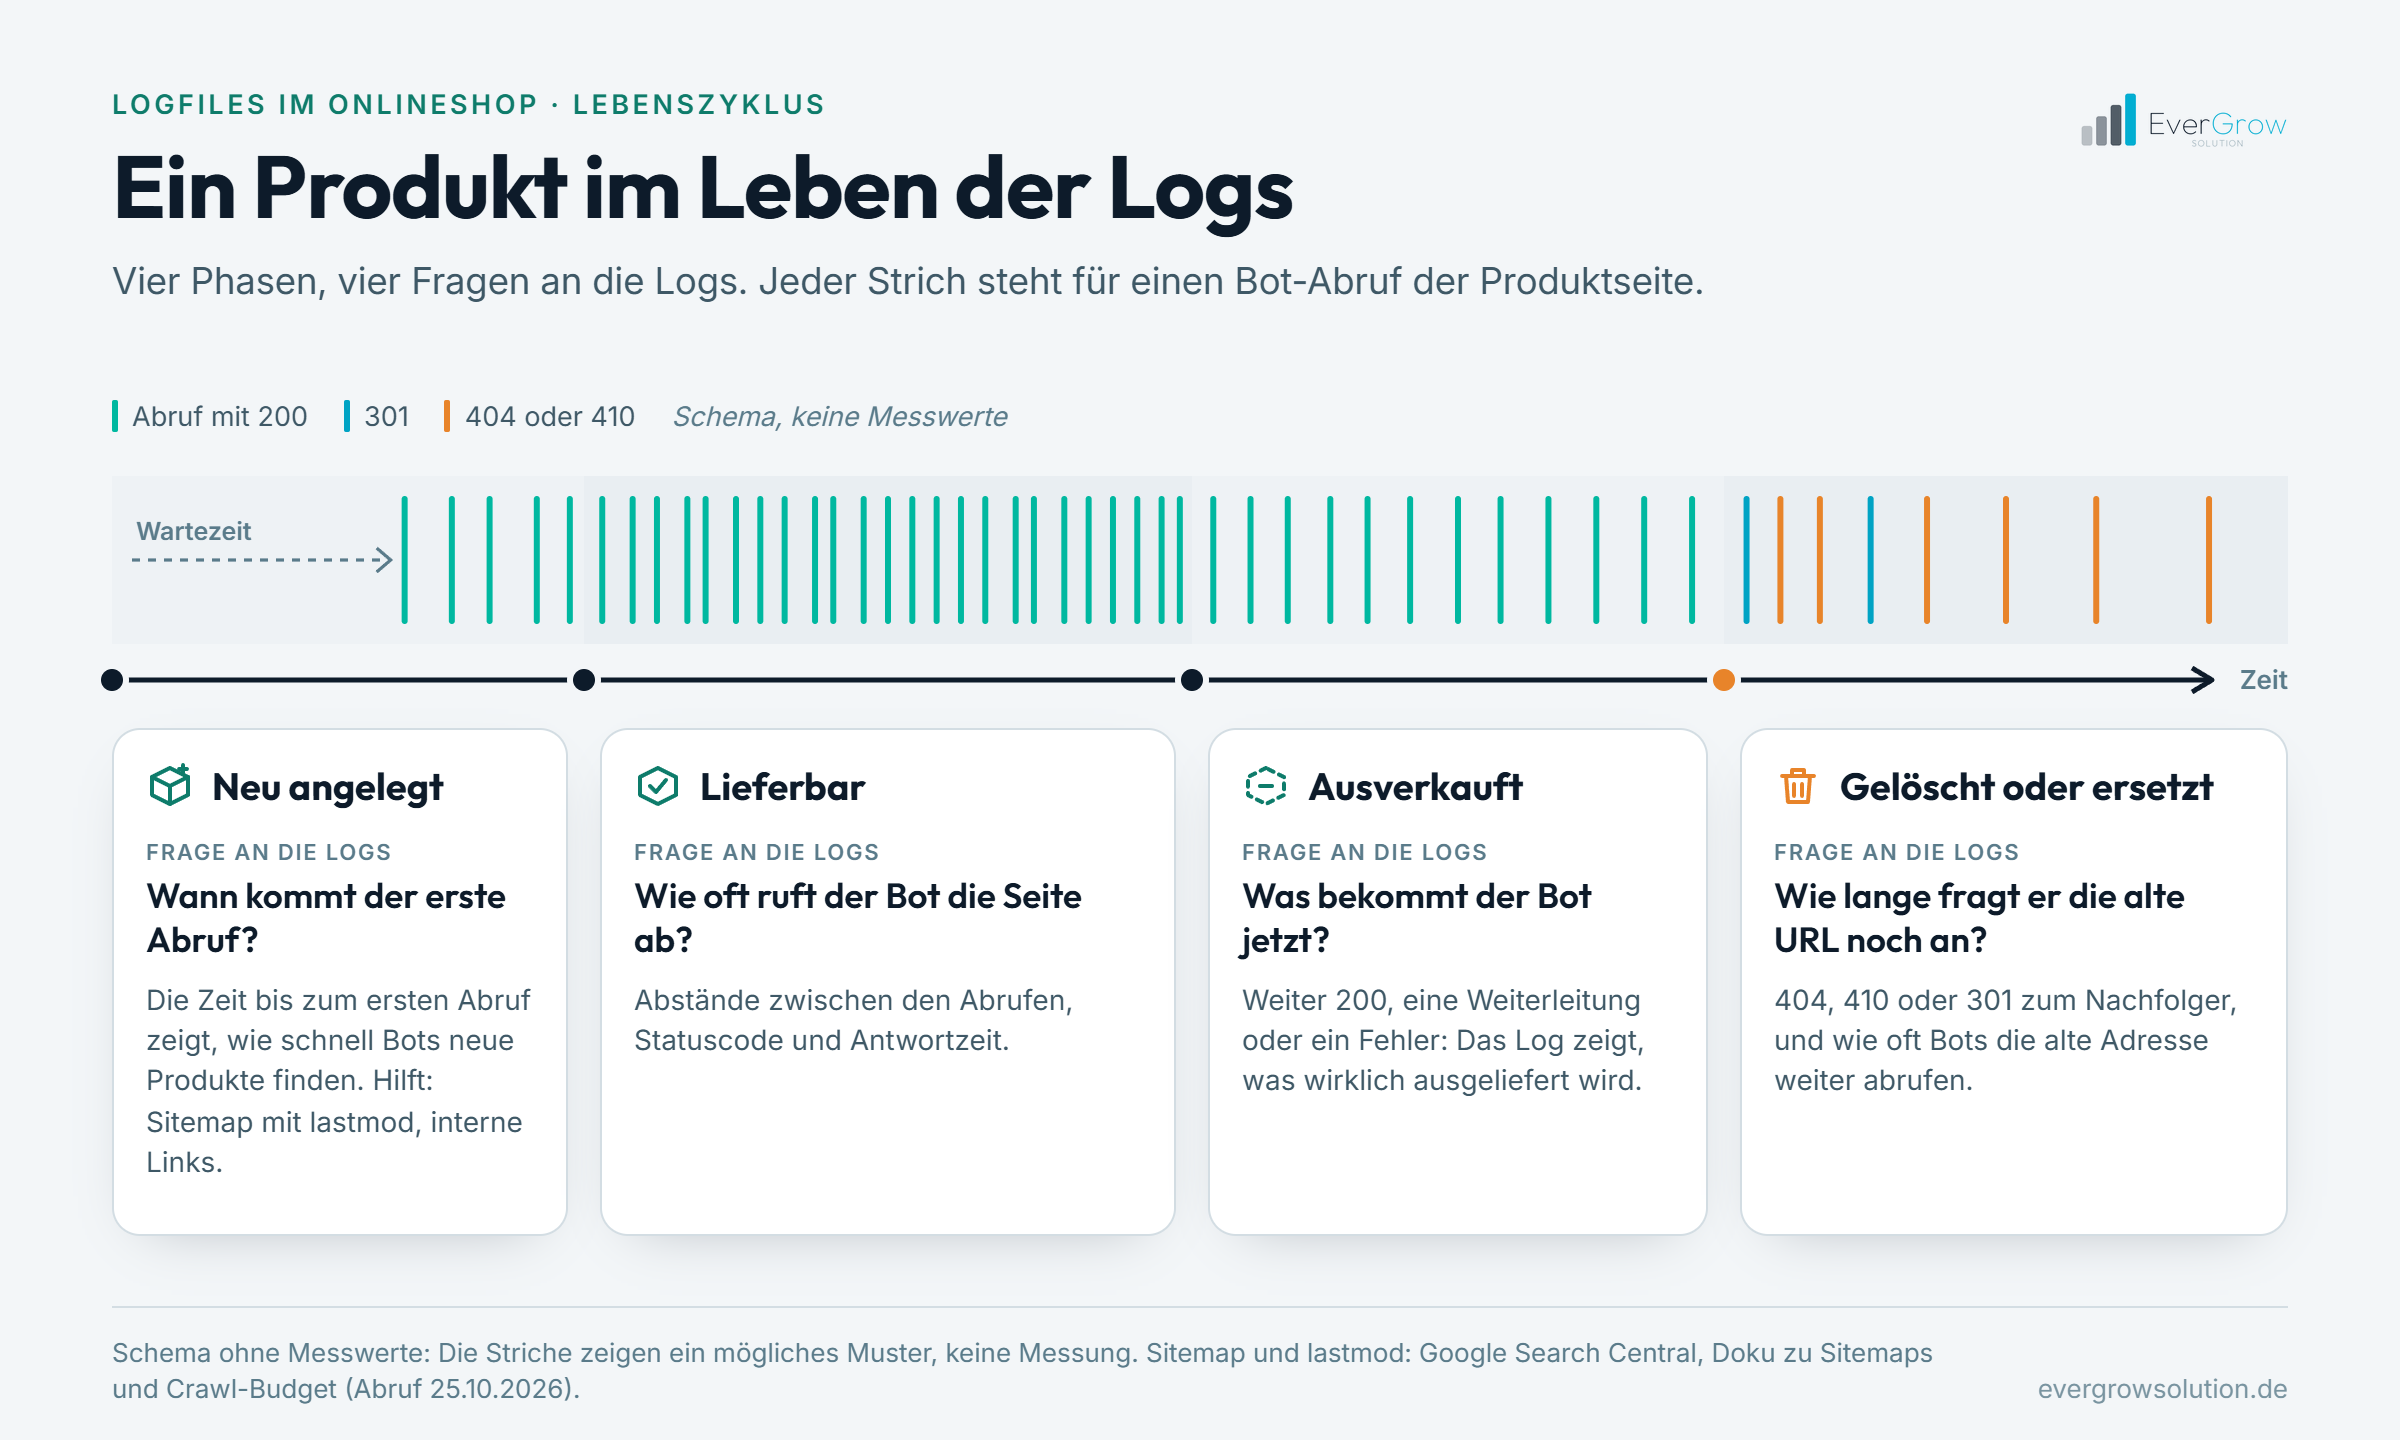
Den Maßstab gibt Google selbst vor: Werden deine Seiten am Tag ihrer Veröffentlichung gecrawlt, brauchst du den Crawling-Budget-Leitfaden nicht (Google). Für einen Shop heißt das: Miss, wie lange ein neues Produkt auf seinen ersten Abruf wartet.
So misst du die Zeit bis zum ersten Abruf
- Nimm für jedes neue Produkt den Zeitpunkt, an dem es online ging, aus dem Shop, nicht aus der Sitemap.
- Such im Log den ersten geprüften Abruf je Bot: Googlebot, Storebot-Google, dazu die Index-Crawler der KI-Suchen wie OAI-SearchBot oder PerplexityBot.
- Die Differenz ist die Zeit bis zum ersten Abruf. Ein Log deckt nur ein Zeitfenster ab: Es ist der erste beobachtete Abruf, nicht zwingend der erste überhaupt.
- Werte nach Kategorie, Marke oder Seitenvorlage aus, nicht nur im Mittel. Ein Durchschnitt versteckt die Sortimentsteile, die wochenlang warten.
Wenn neue Produkte warten
- Sitemap: Google nutzt
<lastmod>nur, wenn der Wert durchgehend und überprüfbar stimmt;changefrequndpriorityignoriert Google (Google: Sitemaps, Stand 15.07.2026). Ein Export, der bei jedem Lauf alle Produkte auf heute setzt, nimmt dem Wert seine Aussage. - Verlinkung: Ist das neue Produkt von einer Seite aus verlinkt, die der Bot oft abruft, etwa Seite 1 der Kategorie oder ein Bereich „Neu“? Das Log zeigt dir, welche Seiten das sind.
- Server: Bei längeren Antwortzeiten und Serverfehlern senkt Google die Crawl-Kapazität. Serverfehler und 429 bremsen die Crawler vorübergehend (Google: HTTP-Statuscodes).
- Filter: Was Filteradressen an Abrufen verbrauchen, fehlt neuen Produkten. Das ist Googles eigene Begründung im Leitfaden zur Facettennavigation.
Ausverkauft, gelöscht, ersetzt: was Bots danach abrufen
Sortimente drehen sich. Für jede Phase gibt es eine passende Antwort, und das Log zeigt, ob die Bots sie so bekommen:
| Situation | Antwort | Was das Log zeigt |
|---|---|---|
| Vorübergehend ausverkauft | Seite bleibt mit 200, Verfügbarkeit in Markup und Feed aktualisieren. Mit automatischen Artikelaktualisierungen gleicht Google Preis und Verfügbarkeit für Shopping mit der Seite ab (Merchant-Center-Hilfe). | Ob Googlebot und Storebot-Google die Seite weiter abrufen. |
| Dauerhaft entfernt, ohne Nachfolger | 404 oder 410: Das empfiehlt Google für dauerhaft entfernte Seiten. Alle 4xx-Codes außer 429 behandelt Google gleich (HTTP-Statuscodes). | Wie lange Bots noch nachfragen. Google vergisst bekannte Adressen nicht, ein 404 ist aber ein starkes Signal, sie nicht erneut zu crawlen. |
| Ersetzt durch einen Nachfolger | 301 auf den Nachfolger: Der Code steht für „dauerhaft verschoben“ (Google: Weiterleitungen). | Ob der Bot dem Ziel folgt und ob Ketten entstehen. |
| „Nicht mehr verfügbar“ mit 200 | Vermeiden. Eine leere Seite oder Fehlermeldung meldet die Search Console als Soft 404; solche Seiten werden weiter gecrawlt und verbrauchen Budget. | Auffällig kleine Antworten mit 200 auf alten Produktadressen. |
| Per robots.txt gesperrt | Keine Lösung für entfernte Produkte: Gesperrte Adressen bleiben laut Google deutlich länger in der Crawl-Warteschlange. | Neue Abrufe, sobald die Sperre fällt. |
| noindex | Spart keine Abrufe: Google fordert die Seite an und verwirft sie danach. | Weiter regelmäßige Abrufe trotz noindex. |
Quellen, soweit nicht in der Zeile genannt: Crawling-Budget-Leitfaden (Stand 16.09.2026) und HTTP-Statuscodes (Stand 06.03.2026). „Seite bleibt mit 200“ beim vorübergehend ausverkauften Produkt ist meine Empfehlung, keine Google-Vorgabe.
# Drei Produkte über sieben Wochen, nur geprüfte Abrufe.
# Gekürzt auf Datum, Anfrage, Status, Kennung und Größe der Antwort.
02.09.  GET /p/zelt-trio-2/    200  Googlebot        48.310 Bytes  ← lieferbar
16.09.  GET /p/zelt-trio-2/    200  Storebot-Google  47.902 Bytes  ← ausverkauft, noch im Feed
30.09.  GET /p/zelt-trio-2/    404  Googlebot        512 Bytes     ← gelöscht
07.10.  GET /p/schlafsack-s1/  301  Googlebot        178 Bytes     ← ersetzt durch s2
07.10.  GET /p/schlafsack-s2/  200  Googlebot        51.044 Bytes
09.10.  GET /p/isomatte-air/   200  Googlebot        1.204 Bytes   ← „nicht verfügbar“, 200
21.10.  GET /p/zelt-trio-2/    404  Googlebot        512 Bytes     ← Google fragt weiter nach
Bei einem Relaunch betrifft das Tausende Adressen auf einmal. Wie du den Weiterleitungsplan aufbaust und nach dem Livegang nachmisst, steht im Ratgeber Shop-Relaunch und SEO.
Feeds und Google Shopping: ein zweiter Crawler auf deinen Produkten
Wer Produkte über das Merchant Center ausspielt, hat einen zusätzlichen Besucher: Storebot-Google. Einstellungen für diese Kennung wirken laut Google auf alle Flächen von Google Shopping (Google: gängige Crawler, Stand 20.10.2026). In der Crawling-Statistik der Search Console taucht er als eigener Crawler-Typ auf, neben AdsBot. Drei Aussagen von Google erklären, warum das im Log zählt:
- Eigener Bedarf. Google Shopping hat einen höheren Bedarf für Produkte in deinen Merchant-Center-Feeds, AdsBot bei dynamischen Anzeigenzielen.
- Geteilte Kapazität. Jeder Crawler hat seinen eigenen Bedarf, die Crawl-Kapazität teilen sich aber alle (beides Crawling-Budget-Leitfaden).
- Seite statt Feed. Mit den automatischen Artikelaktualisierungen gleicht Google Preis, Sonderangebotspreis, Verfügbarkeit und Zustand mit deiner Landingpage ab und liest dafür die strukturierten Daten (Merchant-Center-Hilfe).
Prüffragen für dein Log
- Ruft Storebot-Google die Produkte ab, die im Feed stehen, und welche Statuscodes bekommt er?
- Gehen Abrufe auf Feed- oder Kampagnenadressen mit Parametern wie
utm_sourceodersrsltid(automatische Kennzeichnung im Merchant Center) statt auf die kanonische Produktadresse? Jede Schreibweise einer Adresse kostet einen eigenen Abruf. - Bekommen Shopping- und Anzeigen-Crawler dieselbe Antwort wie Besucher, oder greift eine Firewall-Regel ein?
Mehr Abrufe durch Storebot-Google sind kein Problem, solange der Server sie trägt. Kritisch wird es, wenn Antwortzeiten steigen oder Fehler auftreten: Dann senkt Google die Kapazität für alle Crawler, auch für den Googlebot.
KI-Bots auf Produktseiten: wer liest, und was kommt an
KI-Bots rufen aus drei Gründen ab: fürs Training (GPTBot, ClaudeBot), für einen Suchindex (OAI-SearchBot, Claude-SearchBot, PerplexityBot) und als Live-Abruf, wenn jemand im Chat danach fragt (ChatGPT-User, Claude-User, Perplexity-User). So trennen es OpenAI, Anthropic und Perplexity in ihrer Doku. Bei Live-Abrufen greift die robots.txt laut OpenAI möglicherweise nicht, Perplexity-User ignoriert sie laut Perplexity im Allgemeinen. Google-Extended ist nur ein Steuer-Token in der robots.txt: Google ruft mit den normalen Crawlern ab und sendet keine eigene Kennung dafür (Google). Steht „Google-Extended“ trotzdem in einem User-Agent, kommt der Abruf nicht von Google.
# Gekürzt. IPs aus dem Dokumentationsbereich (RFC 5737); echte Adressen prüfst du
# gegen die veröffentlichte Liste des jeweiligen Betreibers.
203.0.113.24  GET /p/trailjacke/               200  OAI-SearchBot  ← Suchindex
203.0.113.81  GET /p/trailjacke/               200  ChatGPT-User   ← jemand fragt im Chat danach
203.0.113.81  GET /p/trailjacke/?variant=4712  200  ChatGPT-User
198.51.100.7  GET /herren/jacken/              403  ClaudeBot      ← Firewall sperrt, robots.txt erlaubt
192.0.2.140   GET /.env                        404  GPTBot         ← sucht Zugangsdaten: Kennung prüfen
Dass KI-Bots Produktseiten lesen, zeigen veröffentlichte Messungen:
- Live-Abrufe als Nachfragesignal. In meiner Studie zum ChatGPT-utm-Ausfall waren die ChatGPT-User-Abrufe eines großen Onlinehändlers das stabile Signal: In der Ausfallwoche lagen sie nur rund 20 % unter der Vorwoche, während die gekennzeichneten Klicks um 73 bis 79 % fielen. Die Klicks landeten auf Produkt- und Kategorieseiten, ein Teil kam über Links aus den Produktkarten in ChatGPT (Server-Logs, 1. bis 15. Oktober 2026, anonymisiert).
- JavaScript. Laut Vercel (Dezember 2024) rendert außer AppleBot und Gemini keiner der großen KI-Crawler JavaScript. In meinen eigenen Logs (evergrowsolution.de, 3. August bis 12. Oktober 2026, nur geprüfte Adressen) luden ChatGPT-User, PerplexityBot und ClaudeBot keine einzige JavaScript-Datei; eine kleine Website, also ein Anhaltspunkt, kein Beweis. Veröffentlicht ist das in meiner Studie zu 100 großen Onlineshops. Dort erschien der Preis bei 3 von 54 Shops erst nach JavaScript.
- Ungewollte Sperren. Auf meiner eigenen Website hat der Bot-Schutz des Hosters geprüfte OAI-SearchBot- und ClaudeBot-Abrufe mit 429 beantwortet, ohne dass das irgendwo eingestellt war (ebenfalls in der Studie zu 100 Onlineshops). Ob dein CDN oder deine Firewall KI-Bots ausbremst, siehst du an 403 und 429 im Log. Wie du das bei Cloudflare prüfst, steht im Ratgeber GPTBot, OAI-SearchBot, ChatGPT-User.
- Fälschungen. In meinen eigenen Logs kamen 75 % der GPTBot-Abrufe und 65 % der ChatGPT-User-Abrufe nicht aus den Netzen von OpenAI (3. August bis 14. Oktober 2026, Logfile-Analyse für SEO). Die Anteile hängen von Website und Zeitraum ab, die Regel gilt überall: erst prüfen, dann zählen. Wie du jede Kennung gegen die Liste ihres Betreibers prüfst, steht im Ratgeber Googlebot und KI-Crawler prüfen.
Was Logs nicht zeigen: ob ein Abruf zu einer Nennung in der Antwort führt. Ein Abruf ist kein Zitat. Wie du die Nennung misst, steht im Ratgeber KI-Sichtbarkeit messen.
Logs neben Produktdaten: welche Fragen das beantwortet
Bis hier zeigt das Log, was Bots abrufen. Wirklich nützlich wird es, wenn du daneben legst, was dir jede Seite bringt. Dafür brauchst du je Produkt die kanonische Adresse, den Status (lieferbar, ausverkauft, gelöscht), das Datum, an dem es online ging, eine Umsatz- oder Margenklasse und bei Shopping-Kampagnen die Angabe, ob es im Feed steht. Die eigentliche Arbeit steckt in der Zuordnung: Varianten, Parameter und Weiterleitungen machen aus einem Produkt viele Adressen.
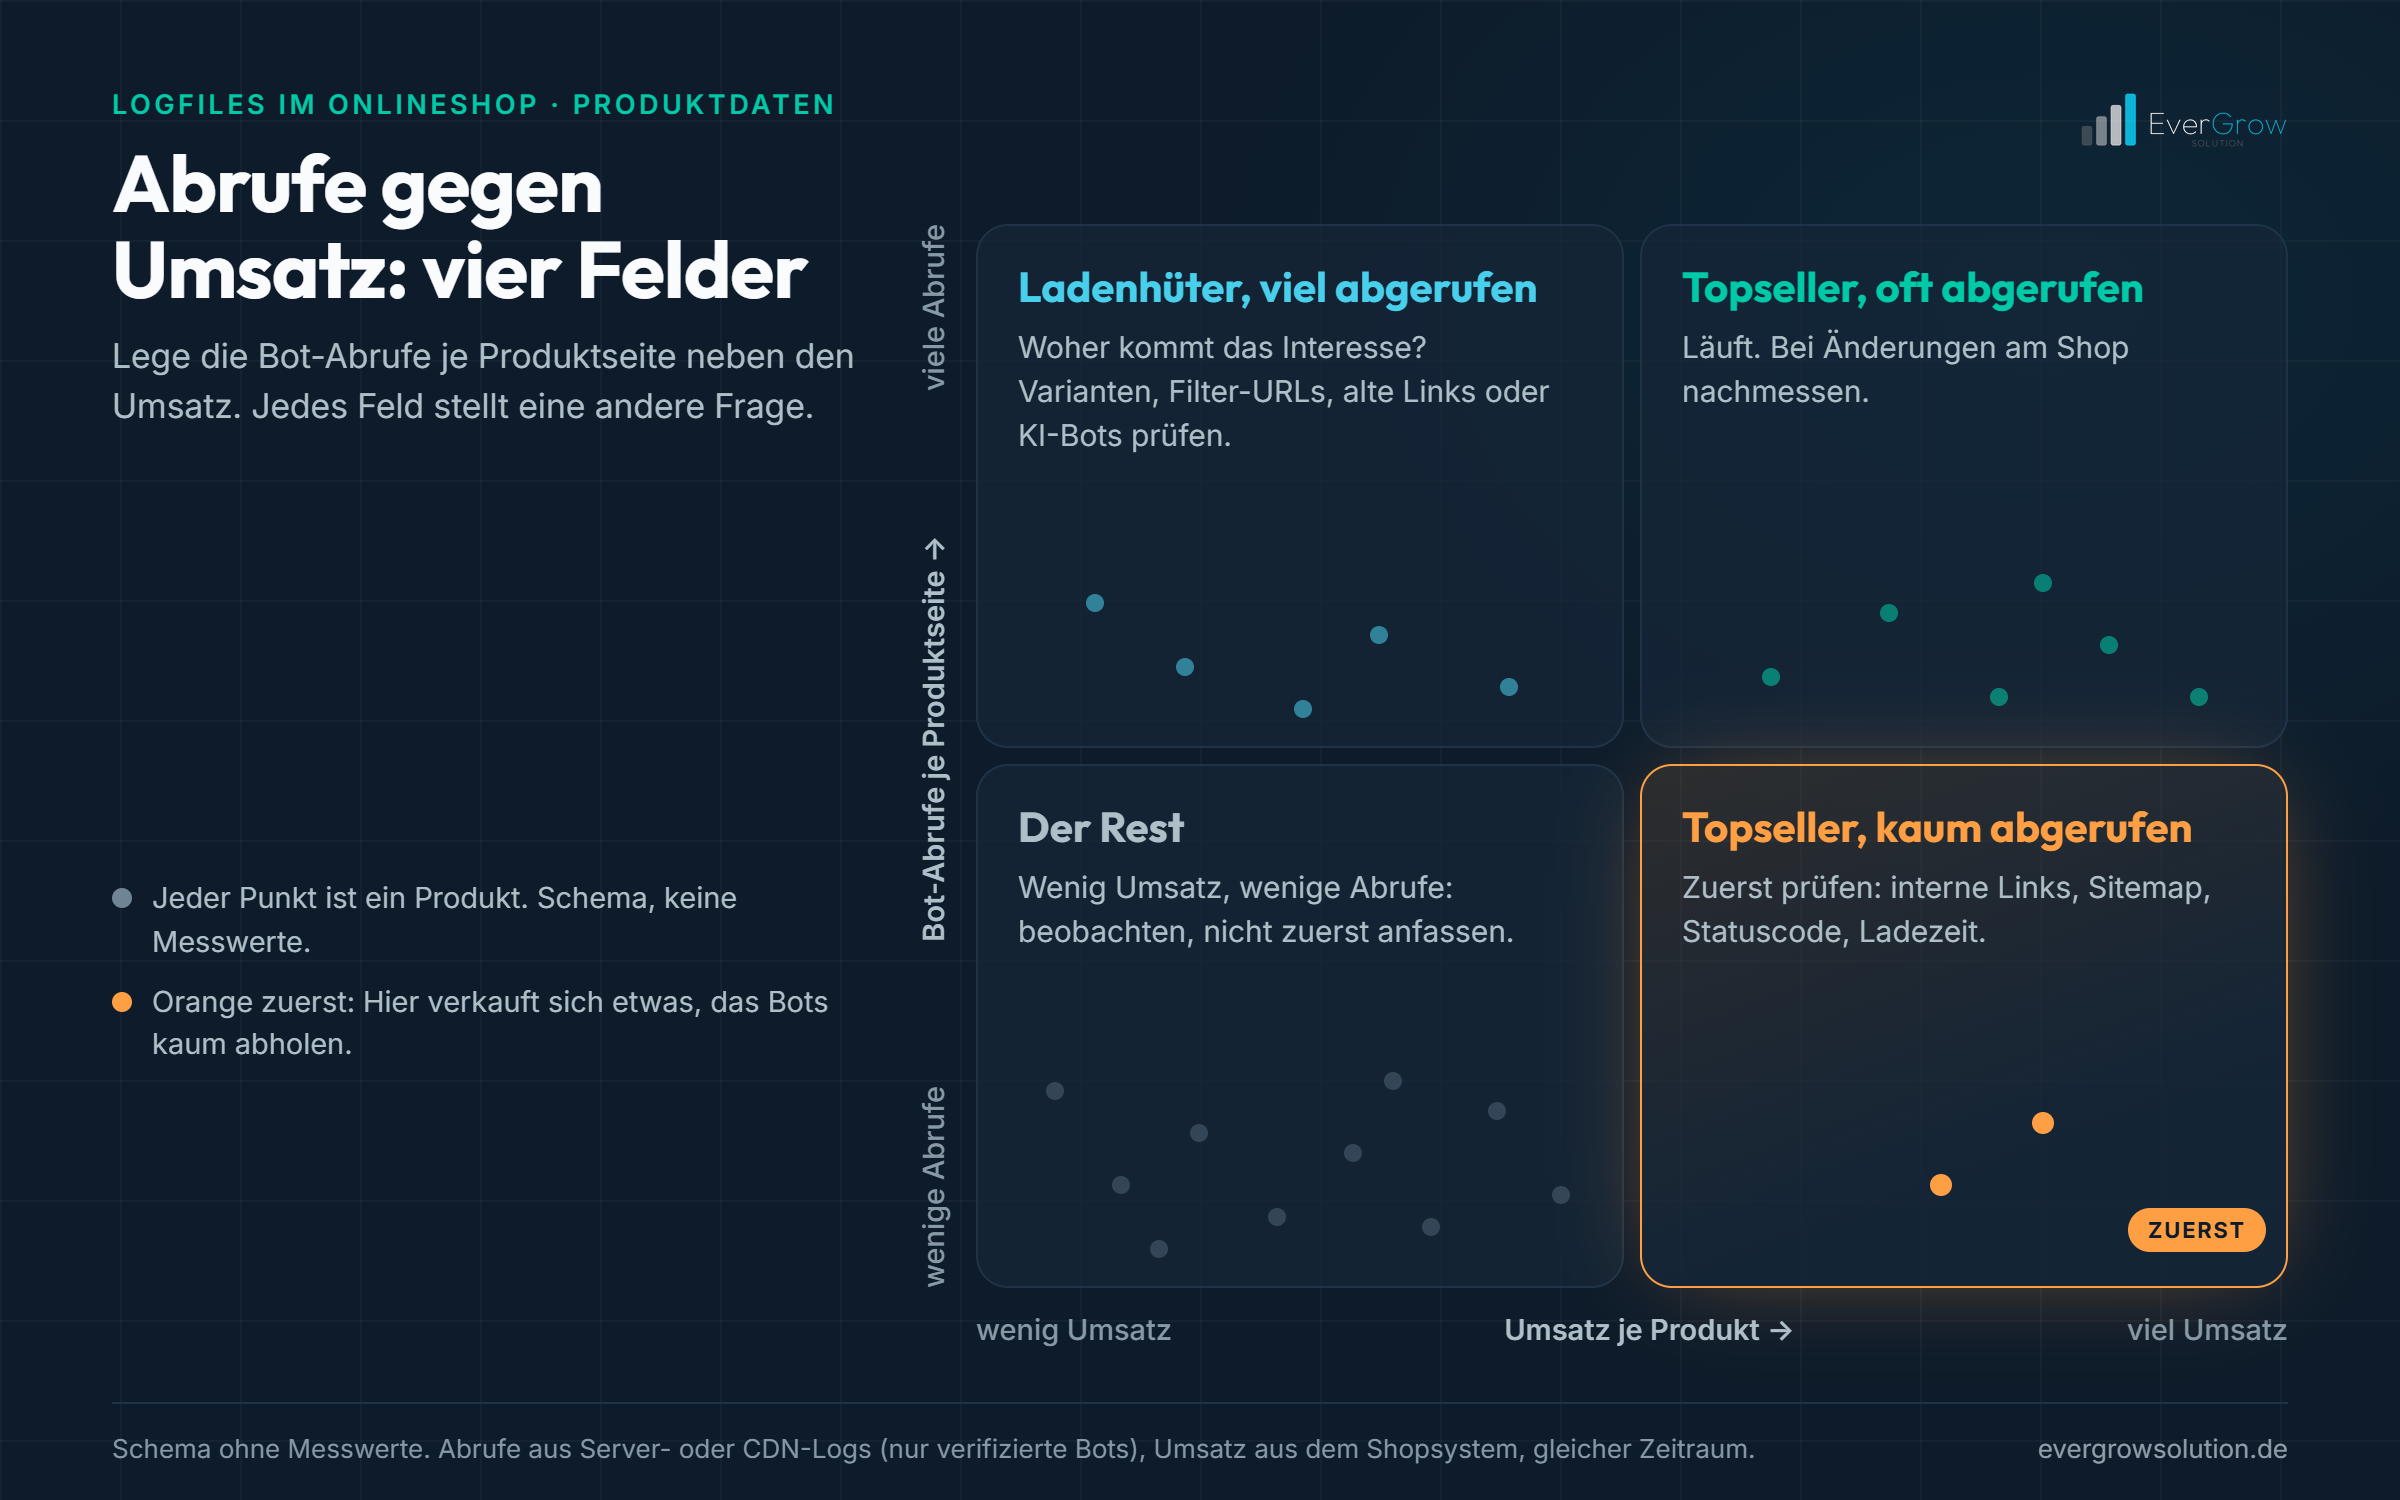
Topseller mit regelmäßigen Abrufen
Hier stimmt die Verteilung. Beobachten, nicht anfassen.
Topseller ohne oder mit seltenen Abrufen
Zuerst ansehen. Ursachen suchst du bei Verlinkung, Canonical, Weiterleitungen, Antwortzeit und Statuscodes.
Ladenhüter oder nicht lieferbare Artikel mit vielen Abrufen
Abrufe, die woanders fehlen können. Prüfe Status, Feed-Eintrag und ob alte Adressen noch verlinkt sind.
Wenig Umsatz, wenig Abrufe
Meist kein Handlungsbedarf, solange nichts davon im Sortiment wichtiger werden soll.
Diese Fragen beantwortet der Vergleich:
- Welche Topseller hat der Googlebot im Messzeitraum nicht oder kaum abgerufen?
- Wie viele Abrufe gehen auf nicht lieferbare oder gelöschte Artikel?
- Wie lange warten neue Produkte je Kategorie auf ihren ersten Abruf?
- Welche Produktseiten holen die Live-Abrufe der KI-Assistenten, und decken sie sich mit deinen Umsatzbringern?
Ab wann sich Logs für deinen Shop lohnen
Google verlangt keine Logs. Im Crawling-Budget-Leitfaden kommen Server-Logs nicht vor. Werden deine Seiten am Tag der Veröffentlichung gecrawlt, reichen laut Google eine aktuelle Sitemap und ein regelmäßiger Blick in den Bericht zur Seitenindexierung (Crawling-Budget-Leitfaden). Die Crawling-Statistik der Search Console brauchst du laut Google bei weniger als 1.000 Seiten wahrscheinlich nicht (Search-Console-Hilfe). Für sehr große Websites, um eine Million Adressen, sagte Gary Illyes 2020 dagegen über Server-Logs: „that can give you the absolute truth“ (Search Engine Journal, 25.08.2020).
Eine feste Produktzahl, ab der es sich lohnt, gibt es deshalb nicht. Diese Fragen helfen dir bei der Entscheidung:
Erzeugen Filter, Sortierung und Varianten deutlich mehr abrufbare Adressen, als du Produkte hast?
Eigener Crawl einer großen Kategorie oder der Facetten-Rechner auf der Seite Technisches SEO.
Steht ein großer Teil deiner Adressen unter „Gefunden – zurzeit nicht indexiert“?
Search Console, Bericht Seitenindexierung. Das ist eines der drei Kriterien, die Google selbst nennt.
Werden neue Produkte am Tag ihrer Veröffentlichung gecrawlt?
URL-Prüfung der Search Console für eine Stichprobe neuer Produkte, Datum des letzten Crawls.
Ändern sich Preise und Bestände täglich, laufen Shopping-Feeds oder dynamische Anzeigen?
Dann holen mehrere Google-Crawler deine Produkte ab und teilen sich die Kapazität deines Servers.
Zeigt die Crawling-Statistik steigende Antwortzeiten, Serverfehler oder 429?
Search Console, Crawling-Statistik. Google drosselt dann für alle Crawler.
Steht eine Entscheidung zu KI-Bots an, oder ist Sichtbarkeit in ChatGPT & Co. ein Ziel?
KI-Bots siehst du weder in der Search Console noch in Analytics. Dafür sind Logs die einzige Quelle.
Steht ein Relaunch, ein Shopsystem-Wechsel oder ein großer Sortimentsumbau an?
Vorher aufzeichnen, nachher vergleichen. Rückwirkend gibt es keine Logs.
Kommst du überhaupt an die Logs?
Siehe Tabelle oben. Wenn nicht: erst den Datenweg klären, dann über die Analyse reden.
Je mehr Fragen du mit Ja beantwortest, desto mehr zeigt dir das Log, was Search Console und Analytics nicht zeigen. Bei Frage 6 ist es die einzige Quelle. Wie die Logs mit Kategorien, Produktdaten und Technik zusammenspielen, beschreibe ich unter E-Commerce-SEO.
Quellen und Stand
Stand: 25. Oktober 2026. Alle Quellen an diesem Tag abgerufen; das Datum hinter einer Google-Seite ist ihr eigener Stand.
- Google, Crawling: Crawling-Budget-Leitfaden (16.09.2026), Facettennavigation (06.03.2026), HTTP-Statuscodes (06.03.2026), Weiterleitungen (20.04.2026), Sitemaps (15.07.2026), gängige Crawler, Storebot-Google und Google-Extended (20.10.2026).
- Google, E-Commerce: Paginierung und schrittweises Laden (18.12.2025), Produktvarianten (12.09.2026), automatische Artikelaktualisierungen im Merchant Center, automatische Kennzeichnung.
- Google, Messung: Crawling-Statistik der Search Console, Ausschluss bekannter Bots in Google Analytics.
- Google-Stimmen: Search Engine Journal, 25.08.2020 (Gary Illyes zu Crawling-Budget und Server-Logs); Search Engine Land zum Podcast „Search Off the Record“ vom 03.02.2026 (Prozentwerte nur in der Sekundärquelle).
- Shopsysteme: Shopify-Hilfe zu Proxys, Cloudflare zu O2O für Shopify, Shopify Log Drains, Shopware Debugging, Shopware Verantwortlichkeiten, Shopware PaaS und Fastly, WooCommerce Status und Protokolle, Adobe Commerce Access-Logs, Adobe Commerce Fastly- und WAF-Logs, JTL-Shop Logbuch.
- CDN: Cloudflare Logpush (Stand 22.10.2026), Akamai DataStream 2, Fastly Log Streaming.
- KI-Bots: OpenAI, Anthropic, Perplexity, Vercel, „The rise of the AI crawler“ (17.12.2024).
- Eigene, bereits veröffentlichte Zahlen: Studie ChatGPT-utm-Ausfall (16.10.2026), Studie KI-Lesbarkeit von 100 Onlineshops, Ratgeber Logfile-Analyse (gefälschte Kennungen, 3.8. bis 14.10.2026).