In vielen Logdateien stehen Abrufe, die sich als Googlebot ausgeben und keiner sind. Bei KI-Bots ebenso, in meinen eigenen Logs bei manchen Kennungen sogar die Mehrheit. Wer nach User-Agent zählt, zählt Scraper und Scanner mit und zieht daraus falsche Schlüsse über Crawl-Budget, KI-Sichtbarkeit und Sperren. Die Search Console hilft dabei nur bei Google: Ihr Crawling-Statistik-Bericht schlüsselt nur Googles eigene Crawler auf, vom Googlebot für Smartphones bis zu AdsBot und StoreBot. KI-Bots siehst du nur in deinen Server- oder CDN-Logs.
Dieser Ratgeber ist die Vertiefung zum Prüfen. Wie eine Logzeile aufgebaut ist und welche Auswertungen für SEO zählen, steht im Ratgeber Logfile-Analyse für SEO. Ob du OpenAIs Bots sperren oder zulassen solltest, klärt der Ratgeber GPTBot, OAI-SearchBot, ChatGPT-User.
KI-Bots in deinen Logs: drei Zwecke
OpenAI und Anthropic führen für jeden Zweck eine eigene Kennung, Perplexity für Suche und Nutzerabruf; Google und Apple trennen zumindest Crawler und Steuer-Token. Der Zweck ist für die Auswertung wichtiger als der Name: Ein Trainings-Crawler sagt nichts über deine Sichtbarkeit in KI-Antworten, ein Nutzerabruf dagegen viel.
- Training: Der Bot sammelt Inhalte, mit denen Modelle trainiert werden können. Beispiele: GPTBot, ClaudeBot.
- Suchindex: Der Bot baut den Index, aus dem eine KI-Suche ihre Quellen holt. Beispiele: OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot.
- Nutzerabruf: Ein Mensch stellt eine Frage, und der Dienst holt dafür live eine Seite. Beispiele: ChatGPT-User, Claude-User, Perplexity-User.
Wie die Abrufe sich verteilen, hat Cloudflare für sein Netz gemessen: In den zwölf Monaten vor seinem Beitrag vom 29. August 2025 dienten 80 Prozent des KI-Crawlings dem Training, 18 Prozent der Suche und 2 Prozent Nutzeraktionen (Cloudflare, 29.08.2025). In deinen Logs kann das ganz anders aussehen. Deshalb lohnt es sich, die drei Zwecke getrennt zu zählen.
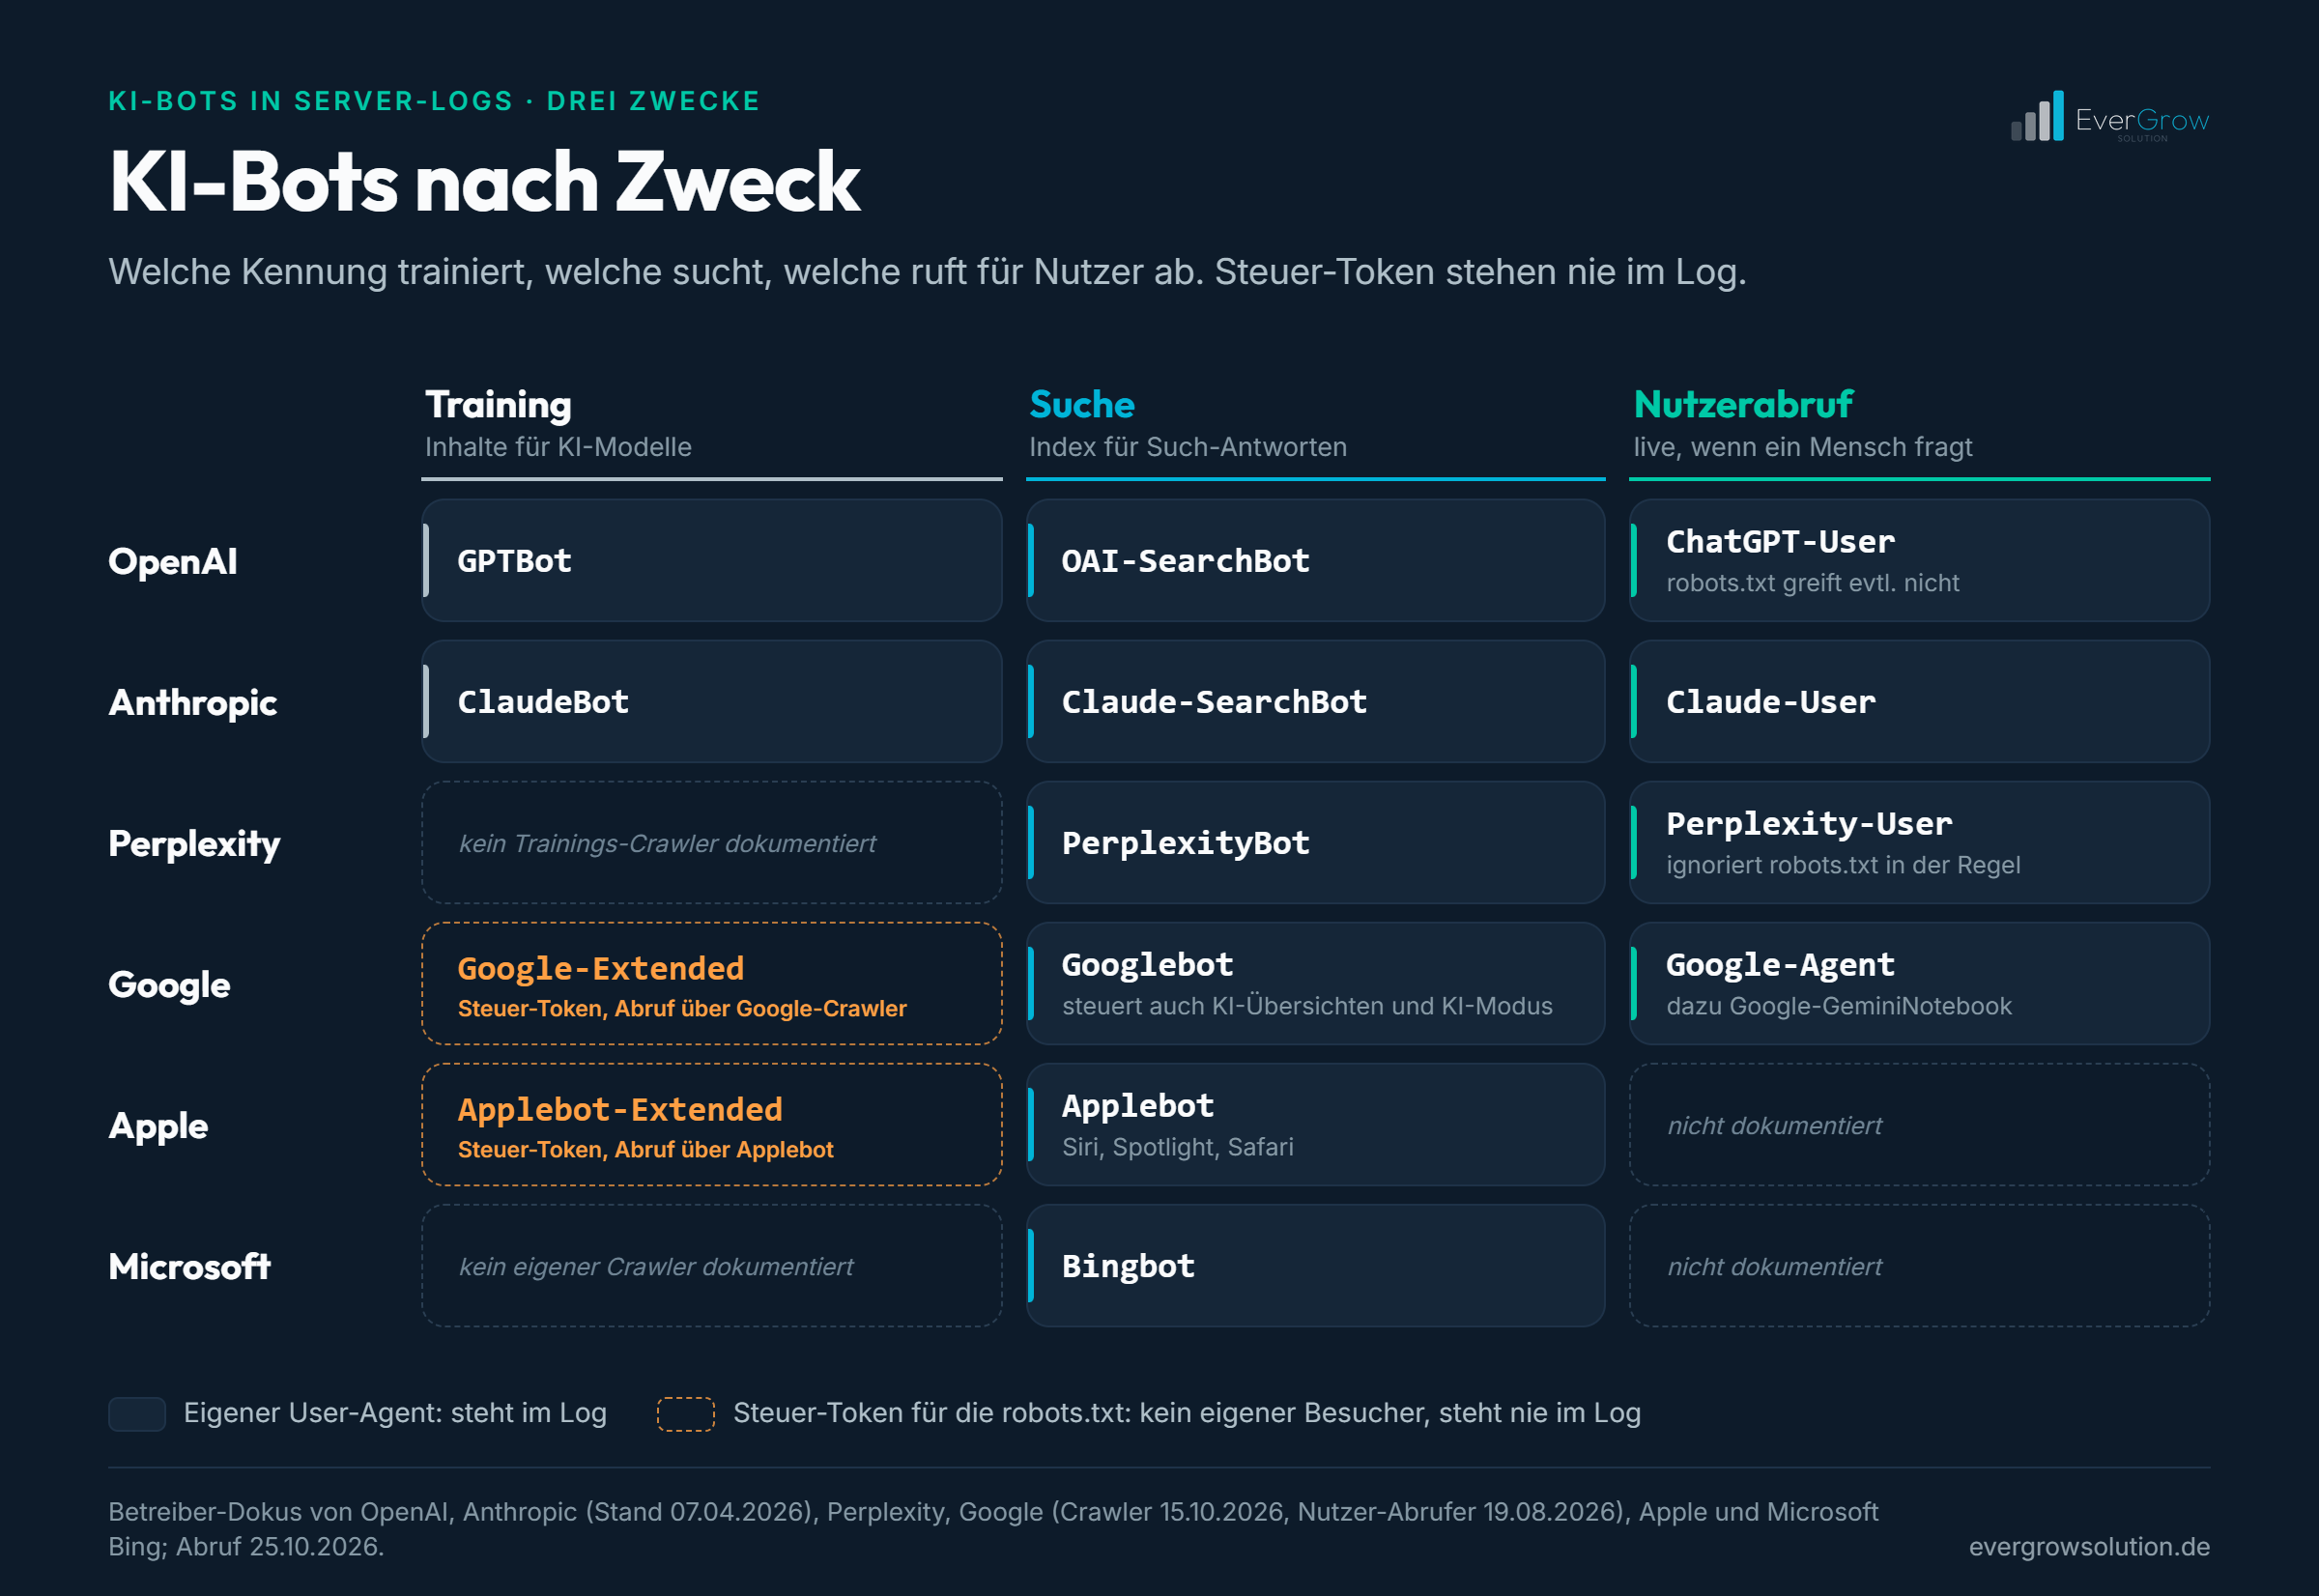
Die Tabelle fasst zusammen, was die Betreiber selbst dokumentieren. Die Spalte „robots.txt laut Betreiber“ gibt ihre Aussage wieder, nicht meine Beobachtung.
| Betreiber | Kennung | Zweck | robots.txt laut Betreiber | Prüfweg |
|---|---|---|---|---|
| GoogleDokuDoku aktualisiert 15.10.2026 | Googlebot | Suchindex. Für KI-Übersichten und KI-Modus verweist Google auf dieselben robots.txt-Regeln für Googlebot. | Beachtet robots.txt bei automatischen Crawls. | Liste common-crawlers.json oder Reverse-DNS auf googlebot.com |
Google-Extended | Steuer-Token für Training künftiger Gemini-Modelle und Grounding. | Nur Token in robots.txt, kein eigener User-Agent. | Steht nie echt im Log. | |
Google-Agent, Google-GeminiNotebook u. a. | Nutzerabruf: Abrufe, die ein Nutzer in einem Google-Produkt auslöst. | Ignorieren robots.txt in der Regel. | Drei Listen für nutzerausgelöste Abrufer; DNS auf google.com oder googleusercontent.com | |
| OpenAIDokuohne Datum, abgerufen 25.10.2026 | GPTBot | Training von Grundlagenmodellen. | Disallow heißt: nicht fürs Training verwenden. | gptbot.json |
OAI-SearchBot | Suchindex für die Suche in ChatGPT. | Gesperrte Websites erscheinen nicht in ChatGPT-Suchantworten, können aber als Navigationslink auftauchen. | searchbot.json | |
ChatGPT-User | Nutzerabruf in ChatGPT und Custom GPTs. | robots.txt-Regeln gelten möglicherweise nicht. | chatgpt-user.json | |
| AnthropicDokuArtikel vom 07.04.2026 | ClaudeBot | Training der KI-Modelle. | Beachtet robots.txt, auch Crawl-delay. | bots.json (eine Liste für alle drei) |
Claude-SearchBot | Suchindex: verbessert die Suchergebnisse in Claude. | Beachtet robots.txt. | bots.json | |
Claude-User | Nutzerabruf auf eine Frage in Claude. | Beachtet robots.txt; eine Sperre verhindert den Abruf. | bots.json | |
| PerplexityDokuohne Datum, abgerufen 25.10.2026 | PerplexityBot | Suchindex für Perplexity, laut Betreiber kein Training. | Über robots.txt steuerbar, Perplexity empfiehlt die Freigabe; Änderungen bis zu 24 Stunden. | perplexitybot.json |
Perplexity-User | Nutzerabruf, kein Crawling, kein Training. | Ignoriert robots.txt in der Regel. | perplexity-user.json | |
| AppleDokuArtikel vom 04.09.2026 | Applebot | Suchindex für Spotlight, Siri und Safari; die Daten können auch Apples Grundlagenmodelle trainieren. | Beachtet robots.txt; ohne eigene Regel gelten die Googlebot-Regeln. Crawl-delay nicht. | applebot.json oder Reverse-DNS auf applebot.apple.com |
Applebot-Extended | Steuer-Token gegen Training mit den Daten, die Applebot gecrawlt hat. | Nur Token in robots.txt; laut Apple crawlt er keine Seiten. | Steht nicht als Crawler im Log. | |
| MicrosoftDokuPrüfweg im Bing-Blog vom 31.08.2012 | Bingbot | Suchindex von Bing. | – | bingbot.json, Reverse-DNS auf search.msn.com oder Werkzeug „Verify Bingbot“ |
Stand: 25.10.2026. OpenAI führt zusätzlich OAI-AdsBot, der nur als Anzeige eingereichte Seiten prüft (Liste adsbot.json). Für Bingbot habe ich nur den dokumentierten Prüfweg übernommen. Weitere Betreiber wie Common Crawl oder Meta sind hier nicht aufgenommen.
Steuer-Token: warum Google-Extended nie im Log steht
Zwei Namen, die in vielen KI-Bot-Listen stehen, wirst du in echten Logzeilen nie finden. Sie sind keine Crawler, sondern Schalter in der robots.txt.
- Google-Extended: Google schreibt: „Google-Extended doesn't have a separate HTTP request user agent string.“ Gecrawlt wird mit den vorhandenen Google-Kennungen, das Token in der robots.txt entscheidet nur über die Nutzung für das Training künftiger Gemini-Modelle und für Grounding. Auf Aufnahme und Ranking in der Google-Suche hat es laut Google keinen Einfluss (Google, aktualisiert 15.10.2026).
- Applebot-Extended: Apple schreibt: „Applebot-Extended does not crawl webpages.“ Das Token legt nur fest, wie Apple die Daten nutzen darf, die Applebot gecrawlt hat. Seiten, die es sperren, können weiter in Apples Suchergebnissen erscheinen (Apple, 04.09.2026).
Daraus folgt eine einfache Regel: Steht „Google-Extended“ im User-Agent einer Logzeile, ist der Abruf gefälscht. Google sendet diese Kennung nie. Fälscher schon: In meinen eigenen Logs taucht sie immer wieder auf, ausnahmslos von Adressen außerhalb der Google-Listen. Wer per Suchbefehl nach „Google-Extended“ filtert, um Googles KI-Crawling zu zählen, zählt also nur Fälschungen. Bei „Applebot-Extended“ im User-Agent passt der Abruf ebenfalls nicht zu Apples Doku; prüfe die IP gegen Apples Liste.
Googlebot prüfen: Schritt für Schritt
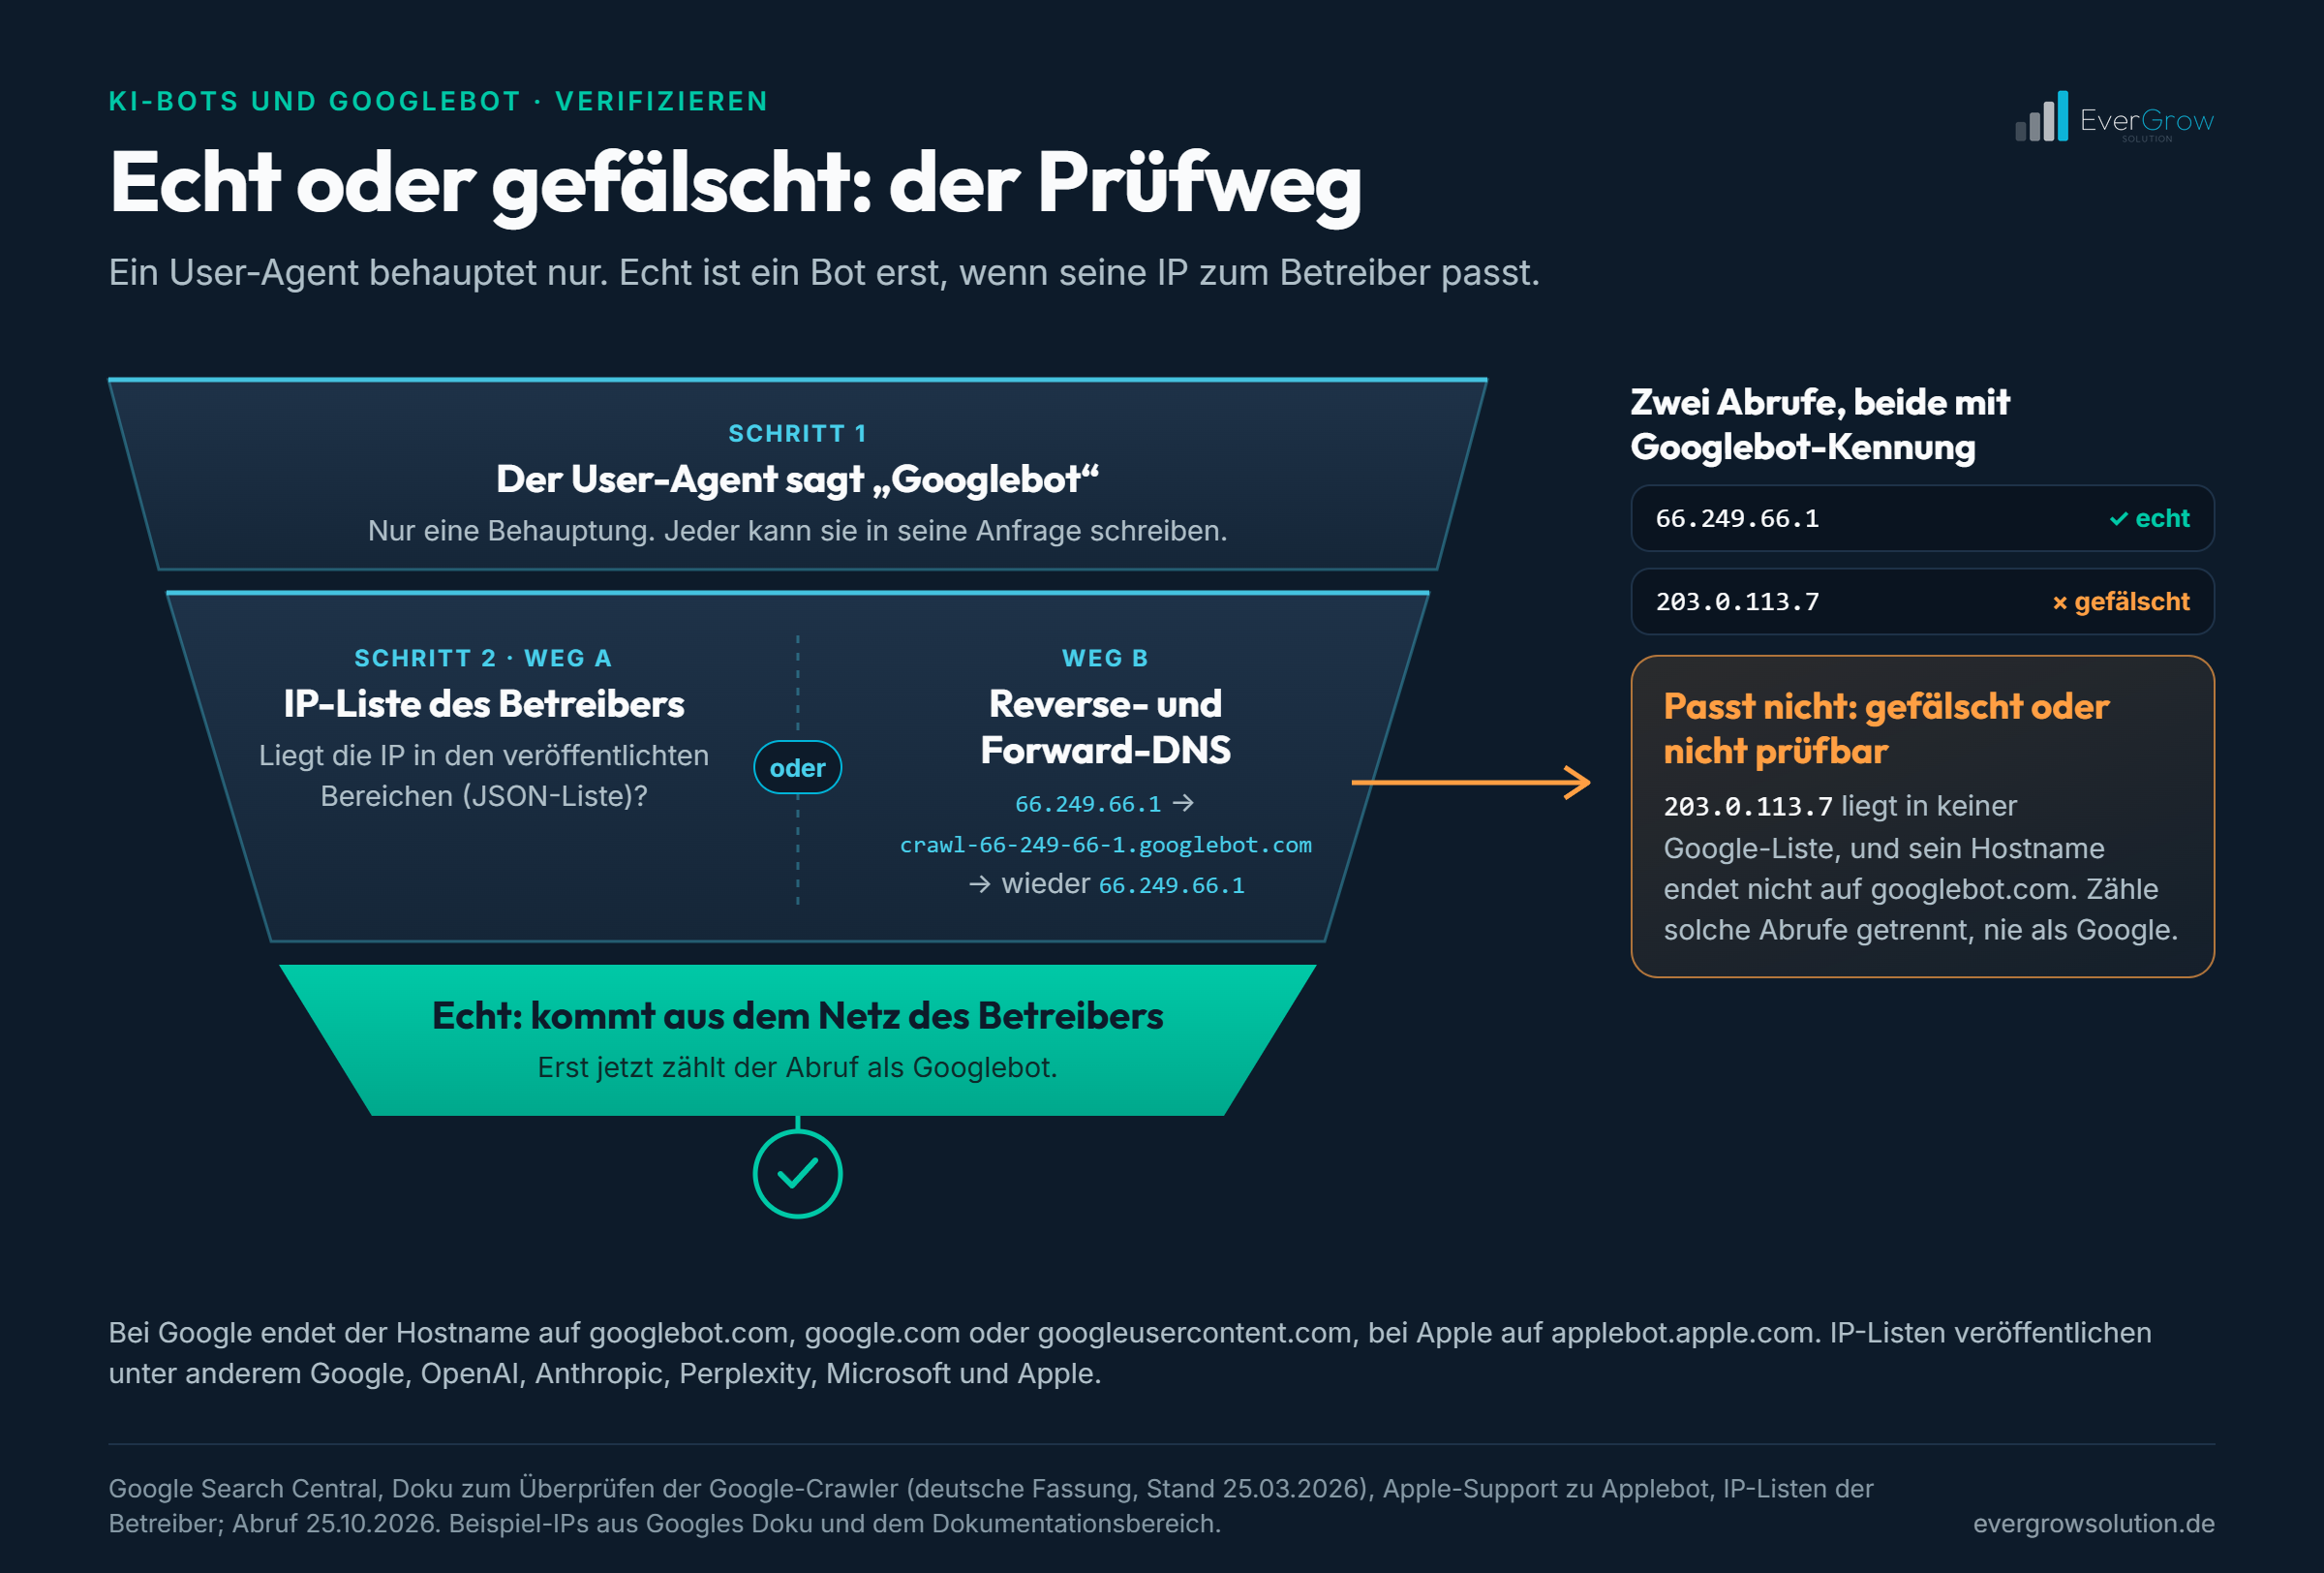
Für alle Betreiber gilt derselbe Grundsatz: Der User-Agent ist eine Behauptung. Bestätigt wird sie nur über die IP-Adresse, entweder über die Liste des Betreibers oder, wo er es dokumentiert, über Reverse- und Forward-DNS. Einzelne IPs oder bis zu 20 Logzeilen kannst du direkt mit dem Bot-Check prüfen.
Welche IP-Adressen nutzt der Googlebot?
Viele Anleitungen nennen 66.249.x.x als Googlebot-Netz. Das stimmt nur zum Teil. In Googles Liste common-crawlers.json standen am 25.10.2026 (Listenstand 23.10.2026) 170 IPv4- und 147 IPv6-Bereiche:
- 122 IPv4-Bereiche in 66.249.x.x,
- 25 in 192.178.x.x,
- 22 in 34.x.x.x und einer in 35.247.x.x,
- alle 147 IPv6-Bereiche unter 2001:4860:4801::.
„Nicht 66.249, also gefälscht“ ist deshalb ein Fehlschluss. Umgekehrt beweist ein Netz, das nach Google aussieht, nichts: In meinen eigenen Logs kamen gefälschte Googlebots unter anderem aus Cloud-Netzen im Bereich 34.x, die nicht auf Googles Crawler-Liste stehen. Entscheidend ist nur der Abgleich mit der Liste oder der DNS-Weg.
Weg 1: Reverse- und Forward-DNS mit host
Google empfiehlt diesen Weg für einzelne Prüfungen und nennt ihn für die meisten Fälle ausreichend (Google, aktualisiert 20.03.2026):
- Reverse-DNS der IP aus deinem Log abfragen.
- Prüfen, ob der Hostname auf
googlebot.com,google.comodergoogleusercontent.comendet. - Forward-DNS dieses Hostnamens abfragen.
- Prüfen, ob dabei dieselbe IP herauskommt wie im Log.
# Schritt 1: Reverse-DNS der IP aus deinem Log
host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.

# Schritt 3: Forward-DNS des Hostnamens
host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1

# Zweites Beispiel aus der Doku: echter Googlebot außerhalb von 66.249.x.x
host 35.247.243.240
240.243.247.35.in-addr.arpa domain name pointer geo-crawl-35-247-243-240.geo.googlebot.com.
Schritt 4 ist der wichtige. Den Reverse-Eintrag einer IP pflegt, wem das Netz gehört. Wer eigene Adressen hat, kann dort jeden Namen eintragen, auch einen, der auf googlebot.com endet. Erst der Forward-Lookup, der zur selben IP zurückführt, schließt das aus.
Weg 2: Abgleich mit Googles IP-Listen
Für viele Abrufe empfiehlt Google den automatischen Abgleich der IP mit den veröffentlichten Bereichen. Google führt dafür fünf Listen, je nach Art des Abrufers. Für sonstige Google-Adressen, etwa von Apps Script, verweist Google auf die allgemeine Liste goog.json. Eine IP daraus zeigt nur ein Google-Netz, keinen bestimmten Crawler.
| Art des Abrufers | IP-Liste | Hostname bei Reverse-DNS |
|---|---|---|
| Gängige Crawler, z. B. Googlebot | common-crawlers.json | crawl-….googlebot.com oder geo-crawl-….geo.googlebot.com |
| Sonderfälle, z. B. AdsBot | special-crawlers.json | rate-limited-proxy-….google.com |
| Nutzerausgelöste Abrufer | user-triggered-fetchers.json | ….gae.googleusercontent.com |
| Nutzerausgelöste Abrufer unter Googles Kontrolle | user-triggered-fetchers-google.json | google-proxy-….google.com |
| Nutzerausgelöste Agenten, z. B. Google-Agent | user-triggered-agents.json | keine eigene Angabe, gehört zur Gruppe der nutzerausgelösten Abrufer |
Quelle: Google, Anfragen von Google-Crawlern prüfen, aktualisiert 20.03.2026; alle fünf Listen am 25.10.2026 abgerufen, Listenstand jeweils 23.10.2026.
Wichtig dabei: Prüfe gegen die Liste, die zur Kennung passt. Ein „Googlebot“ gehört in die Liste der gängigen Crawler. Eine IP aus der Liste der nutzerausgelösten Abrufer bestätigt einen Nutzerabruf, aber keinen Googlebot.
So sieht das in Logzeilen aus
# Beispiel, fiktiv. Drei Zeilen, dreimal „Google“ im User-Agent.
66.249.66.1 - - [25/Oct/2026:06:12:03 +0200] "GET /kategorie/laufschuhe/ HTTP/1.1" 200 51234 "-" "Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/W.X.Y.Z Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"
203.0.113.45 - - [25/Oct/2026:06:12:09 +0200] "GET /.env HTTP/1.1" 404 512 "-" "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"
198.51.100.7 - - [25/Oct/2026:06:13:40 +0200] "GET /produkt/trailschuh-x/ HTTP/1.1" 200 48211 "-" "Mozilla/5.0 (compatible; Google-Extended/1.0; +http://www.google.com/bot.html)"
Zeile 2 zeigt ein typisches Muster: eine Googlebot-Kennung, die nach einer Datei mit Zugangsdaten fragt. Ein echter Googlebot hat dort nichts zu suchen. Zeile 3 braucht gar keine Prüfung mehr, denn Google sendet „Google-Extended“ nie.
Für jede dieser Prüfungen brauchst du die vollständige IP-Adresse. Kürzt dein Hoster oder dein eigener Export die Adressen vorher, lässt sich kein Bot mehr verifizieren. Erst prüfen, dann kürzen: Wie das zum Datenschutz passt, steht im Ratgeber Logfile-Analyse für SEO.
KI-Bots prüfen: GPTBot, ClaudeBot, PerplexityBot und Co.
Bei OpenAI, Anthropic und Perplexity ist der Weg kürzer und strenger zugleich: Sie veröffentlichen IP-Listen, dokumentieren auf ihren Bot-Seiten aber keinen Reverse-DNS-Weg. Übertrage Googles DNS-Muster deshalb nicht auf sie. Die IP muss in der Liste stehen, die zur Kennung gehört. Perplexity rät ausdrücklich, User-Agent und IP-Adresse immer zusammen zu prüfen.
OpenAI: GPTBot, OAI-SearchBot, ChatGPT-User
OpenAI führt für jede Kennung eine eigene Liste: gptbot.json (Stand 22.09.2026), searchbot.json (02.01.2026), chatgpt-user.json (20.10.2026) und adsbot.json (12.05.2026). Ein „GPTBot“ aus einem Netz der ChatGPT-User-Liste ist also kein bestätigter GPTBot. OpenAI empfiehlt, Anfragen aus den veröffentlichten Bereichen durchzulassen (OpenAI, Crawler-Doku).
Zwei Details helfen beim Lesen der Logs. Erstens kann OpenAI beim Abruf der robots.txt den Zusatz „robots.txt“ in den User-Agent schreiben, etwa compatible; OAI-SearchBot/1.4; robots.txt; +https://openai.com/searchbot. Zweitens kann OpenAI ein Crawl-Ergebnis für Training und Suche gemeinsam nutzen, wenn du beide Bots zulässt. Wenige GPTBot-Abrufe neben vielen OAI-SearchBot-Abrufen sind deshalb kein Widerspruch.
Anthropic: ClaudeBot, Claude-SearchBot, Claude-User
Anthropic veröffentlicht eine gemeinsame Liste für alle drei Bots: claude.com/crawling/bots.json (Stand 20.10.2026). Steht die Quell-IP darin, kommt der Abruf laut Anthropic von Anthropic. Eine Liste für alle heißt: Die IP bestätigt den Betreiber, nicht den Zweck. Welcher der drei Bots es war, sagt dir weiter der User-Agent. Anthropic weist außerdem darauf hin, dass Sperren über IP-Adressen möglicherweise nicht richtig funktionieren; gesteuert wird über robots.txt (Anthropic, 07.04.2026).
Perplexity: PerplexityBot, Perplexity-User
Perplexity führt zwei Listen: perplexitybot.json (Stand 07.02.2025) und perplexity-user.json (17.10.2025). Laut Perplexity dient keiner der beiden Bots dem Training von Grundlagenmodellen (Perplexity, Crawler-Doku). Wie du in Perplexity als Quelle erscheinst, steht im Ratgeber Perplexity-SEO.
Apple und Microsoft: DNS wie bei Google
Apple und Microsoft dokumentieren wie Google beide Wege. Applebot erkennst du am Hostnamen unter applebot.apple.com oder an der Liste applebot.json (Stand 15.09.2026). Bingbot löst auf einen Namen unter search.msn.com auf; dazu gibt es die Liste bingbot.json (Stand 03.01.2024) und das Werkzeug Verify Bingbot.
# Apple
host 17.58.101.179
179.101.58.17.in-addr.arpa domain name pointer 17-58-101-179.applebot.apple.com.
host 17-58-101-179.applebot.apple.com
17-58-101-179.applebot.apple.com has address 17.58.101.179

# Microsoft (Bing)
host 157.55.33.18
157.55.33.18.in-addr.arpa domain name pointer msnbot-157-55-33-18.search.msn.com
host msnbot-157-55-33-18.search.msn.com
msnbot-157-55-33-18.search.msn.com has address 157.55.33.18
Was noch kommt: signierte Anfragen
Neben IP-Listen gibt es einen jüngeren Weg: Der Bot signiert jede Anfrage, der Server prüft die Signatur gegen einen öffentlichen Schlüssel. Cloudflare beschreibt das als „Web Bot Auth“ auf Grundlage von IETF-Entwürfen (Cloudflare, aktualisiert 08.10.2026). Die dafür nötigen Kopfzeilen stehen nicht in normalen Access-Logs, und die Bot-Seiten oben nennen als Prüfweg IP-Listen und DNS. Für deine Logs bleibt das vorerst der Weg.
Gefälschte Bot-Kennungen: wie oft das vorkommt
Wie groß das Problem ist, habe ich an meiner eigenen Website gemessen: alle Abrufe vom 3. August bis 14. Oktober 2026, jede IP-Adresse gegen die veröffentlichte Liste des jeweiligen Betreibers geprüft. Der Anteil gibt an, wie viele Abrufe mit dieser Kennung nicht aus den Netzen des Betreibers kamen.
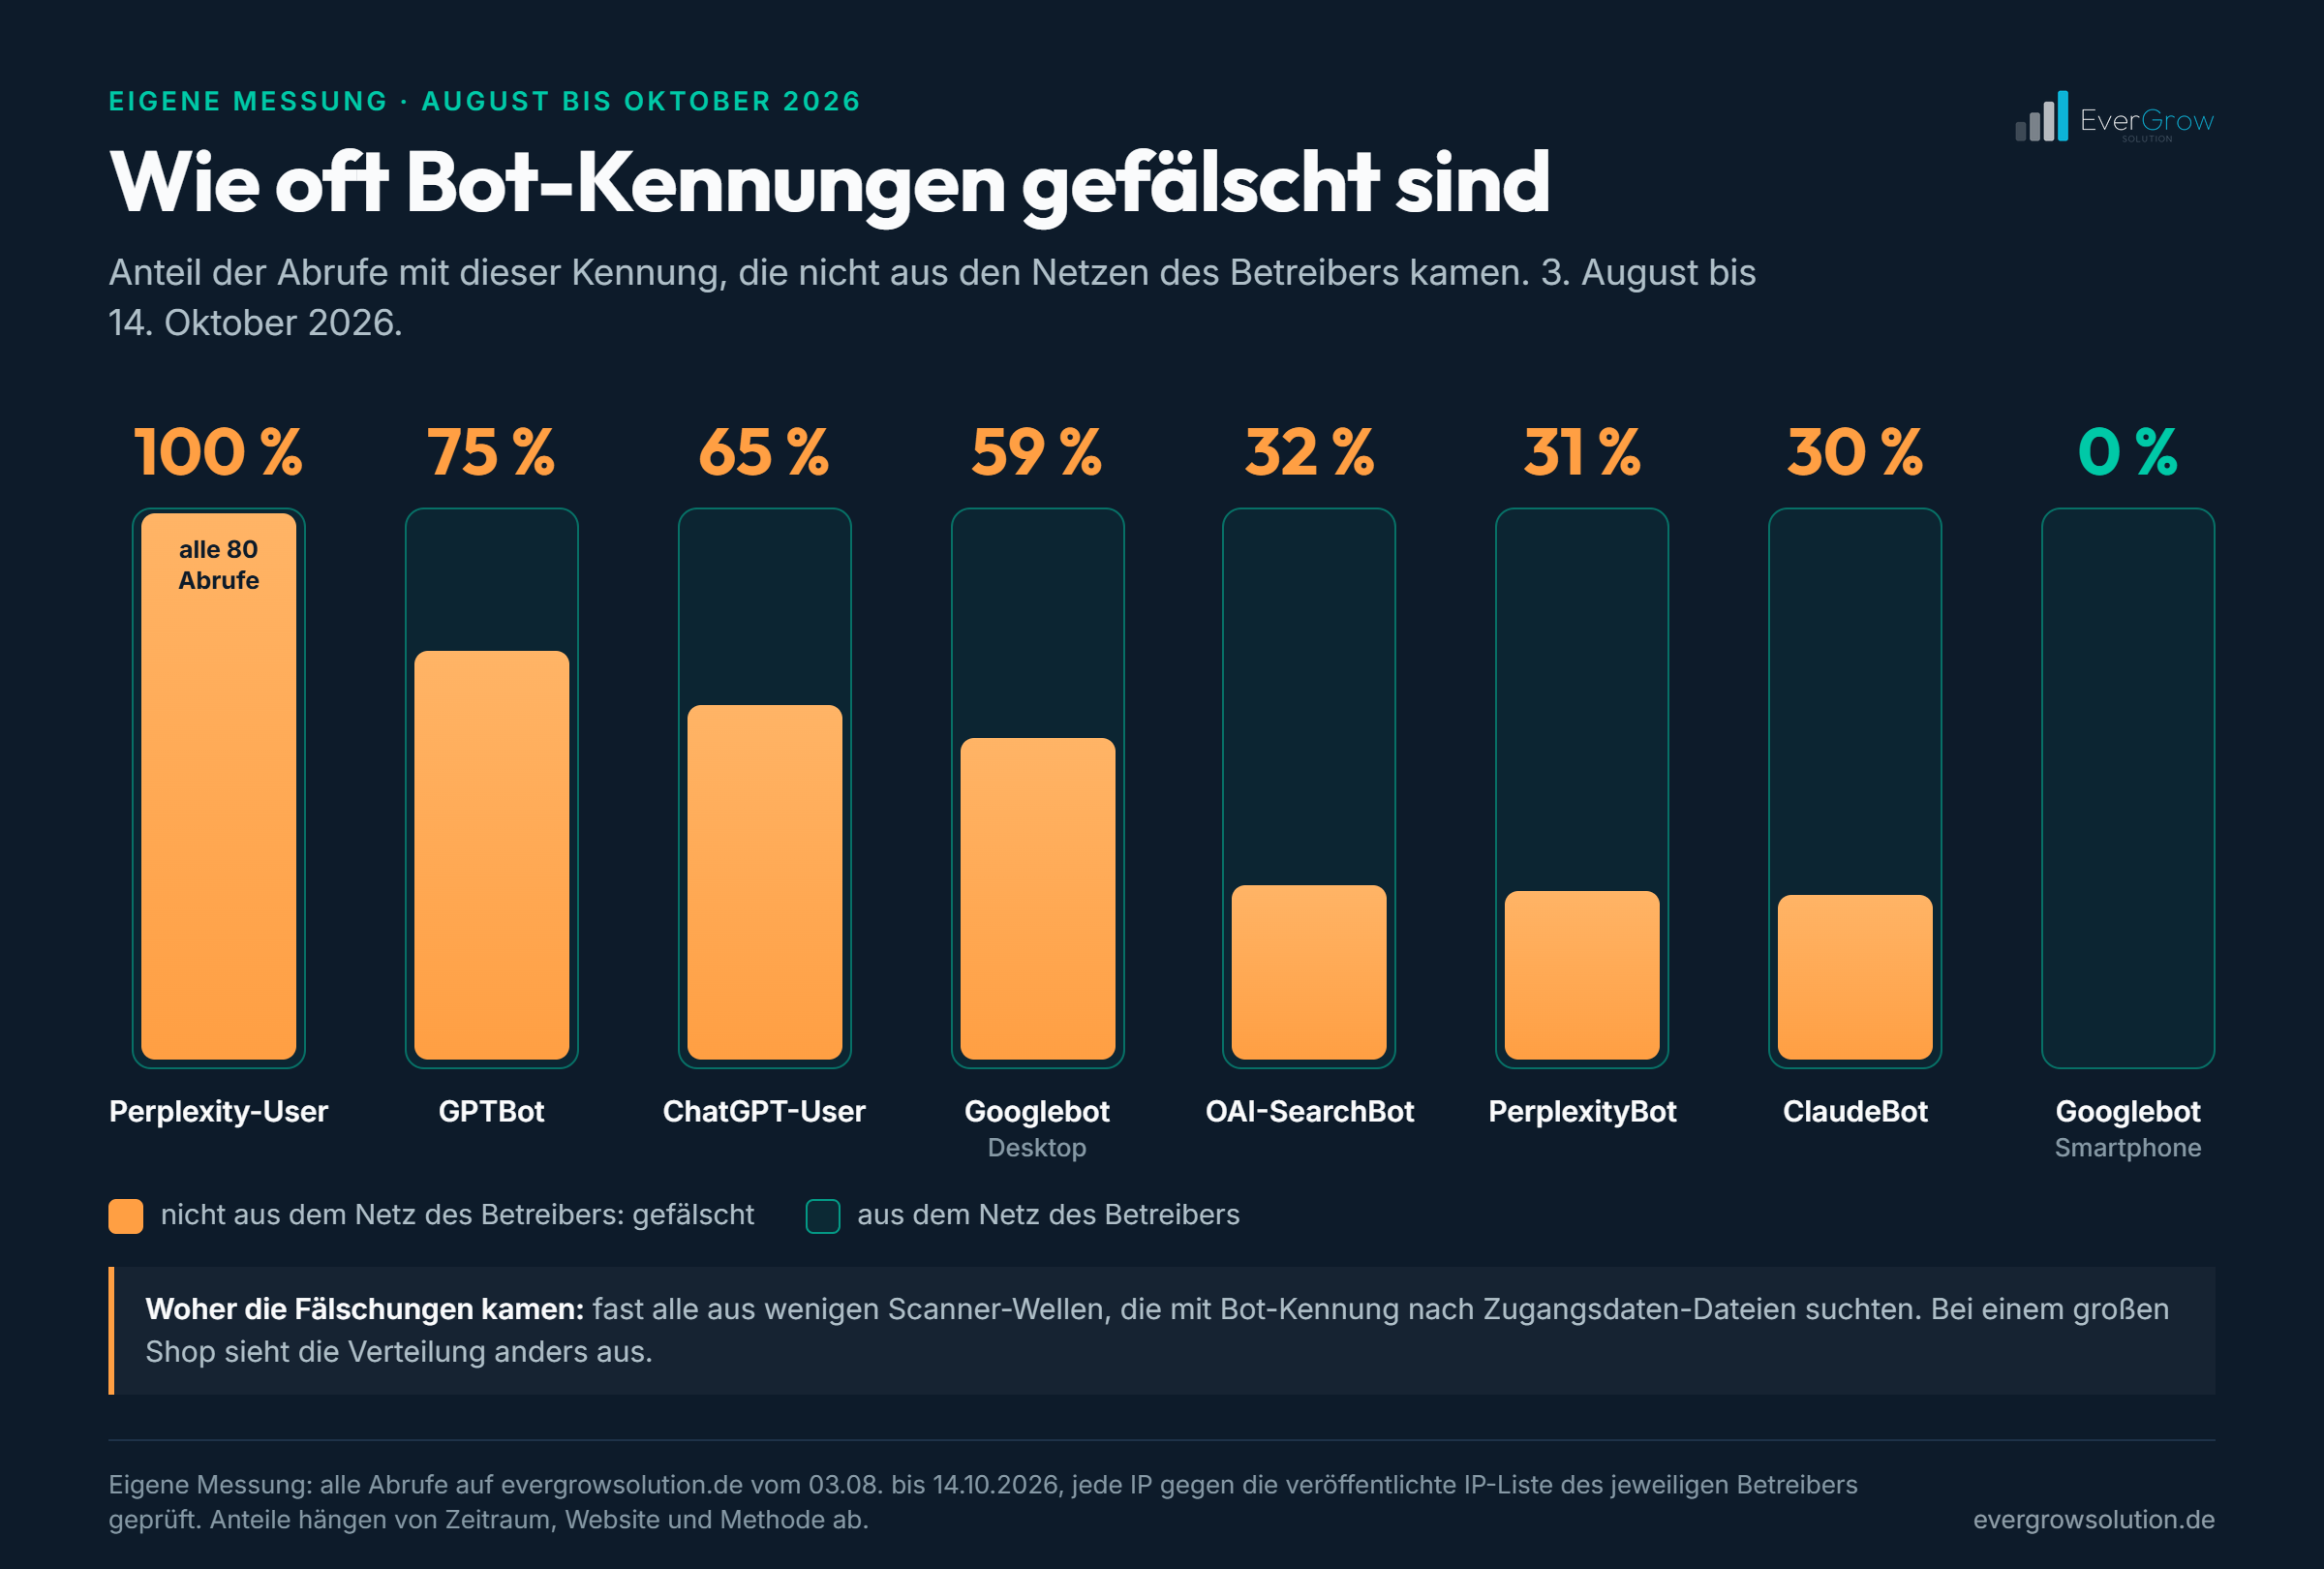
| Kennung im User-Agent | aus fremden Netzen |
|---|---|
| Perplexity-User | alle 80 Abrufe |
| GPTBot | 75 % |
| ChatGPT-User | 65 % |
| Googlebot (Desktop) | 59 % |
| OAI-SearchBot | 32 % |
| PerplexityBot | 31 % |
| ClaudeBot | 30 % |
| Googlebot (Smartphone) | 0 % |
Eigene Website, 3. August bis 14. Oktober 2026, IP gegen die veröffentlichte Liste des Betreibers. Zuerst veröffentlicht im Ratgeber Logfile-Analyse für SEO.
Fast alle Fälschungen kamen aus wenigen Scanner-Wellen, die mit Bot-Kennung nach Zugangsdaten-Dateien suchten. Die Anteile hängen deshalb stark von Zeitraum, Website und Methode ab: Bei einem großen Shop sieht die Verteilung anders aus. Die Richtung gilt trotzdem. Wer Bot-Abrufe nach User-Agent zählt, zählt bei KI-Bots oft mehr Fälschungen als echte Abrufe.
Andere kommen zu ähnlichen Ergebnissen. Duane Forrester hat auf einer neuen, kleinen Website 14 Tage lang jede Googlebot-Kennung gegen Googles veröffentlichte Bereiche geprüft: Von 799 Anfragen mit dem Namen Googlebot kamen 107 von einer bestätigten Google-Adresse (Search Engine Journal, 25.06.2026). Auch das ist ein Einzelfall, aber er zeigt dasselbe: Wer ungeprüft zählt, kann mehr Fälschungen zählen als echte Abrufe.
Kleine Website gegen großen Shop: „außerhalb der Liste“ heißt nicht „gefälscht“
Wie stark das Bild von der Website abhängt, zeigt der Vergleich mit einem großen Onlineshop, dessen Logs ich für die Studie zu KI-Assistenten im Onlineshop ausgewertet habe. Dieselben sechs Bots, dieselbe Prüfung gegen die veröffentlichten IP-Bereiche, zwei sehr verschiedene Ergebnisse:
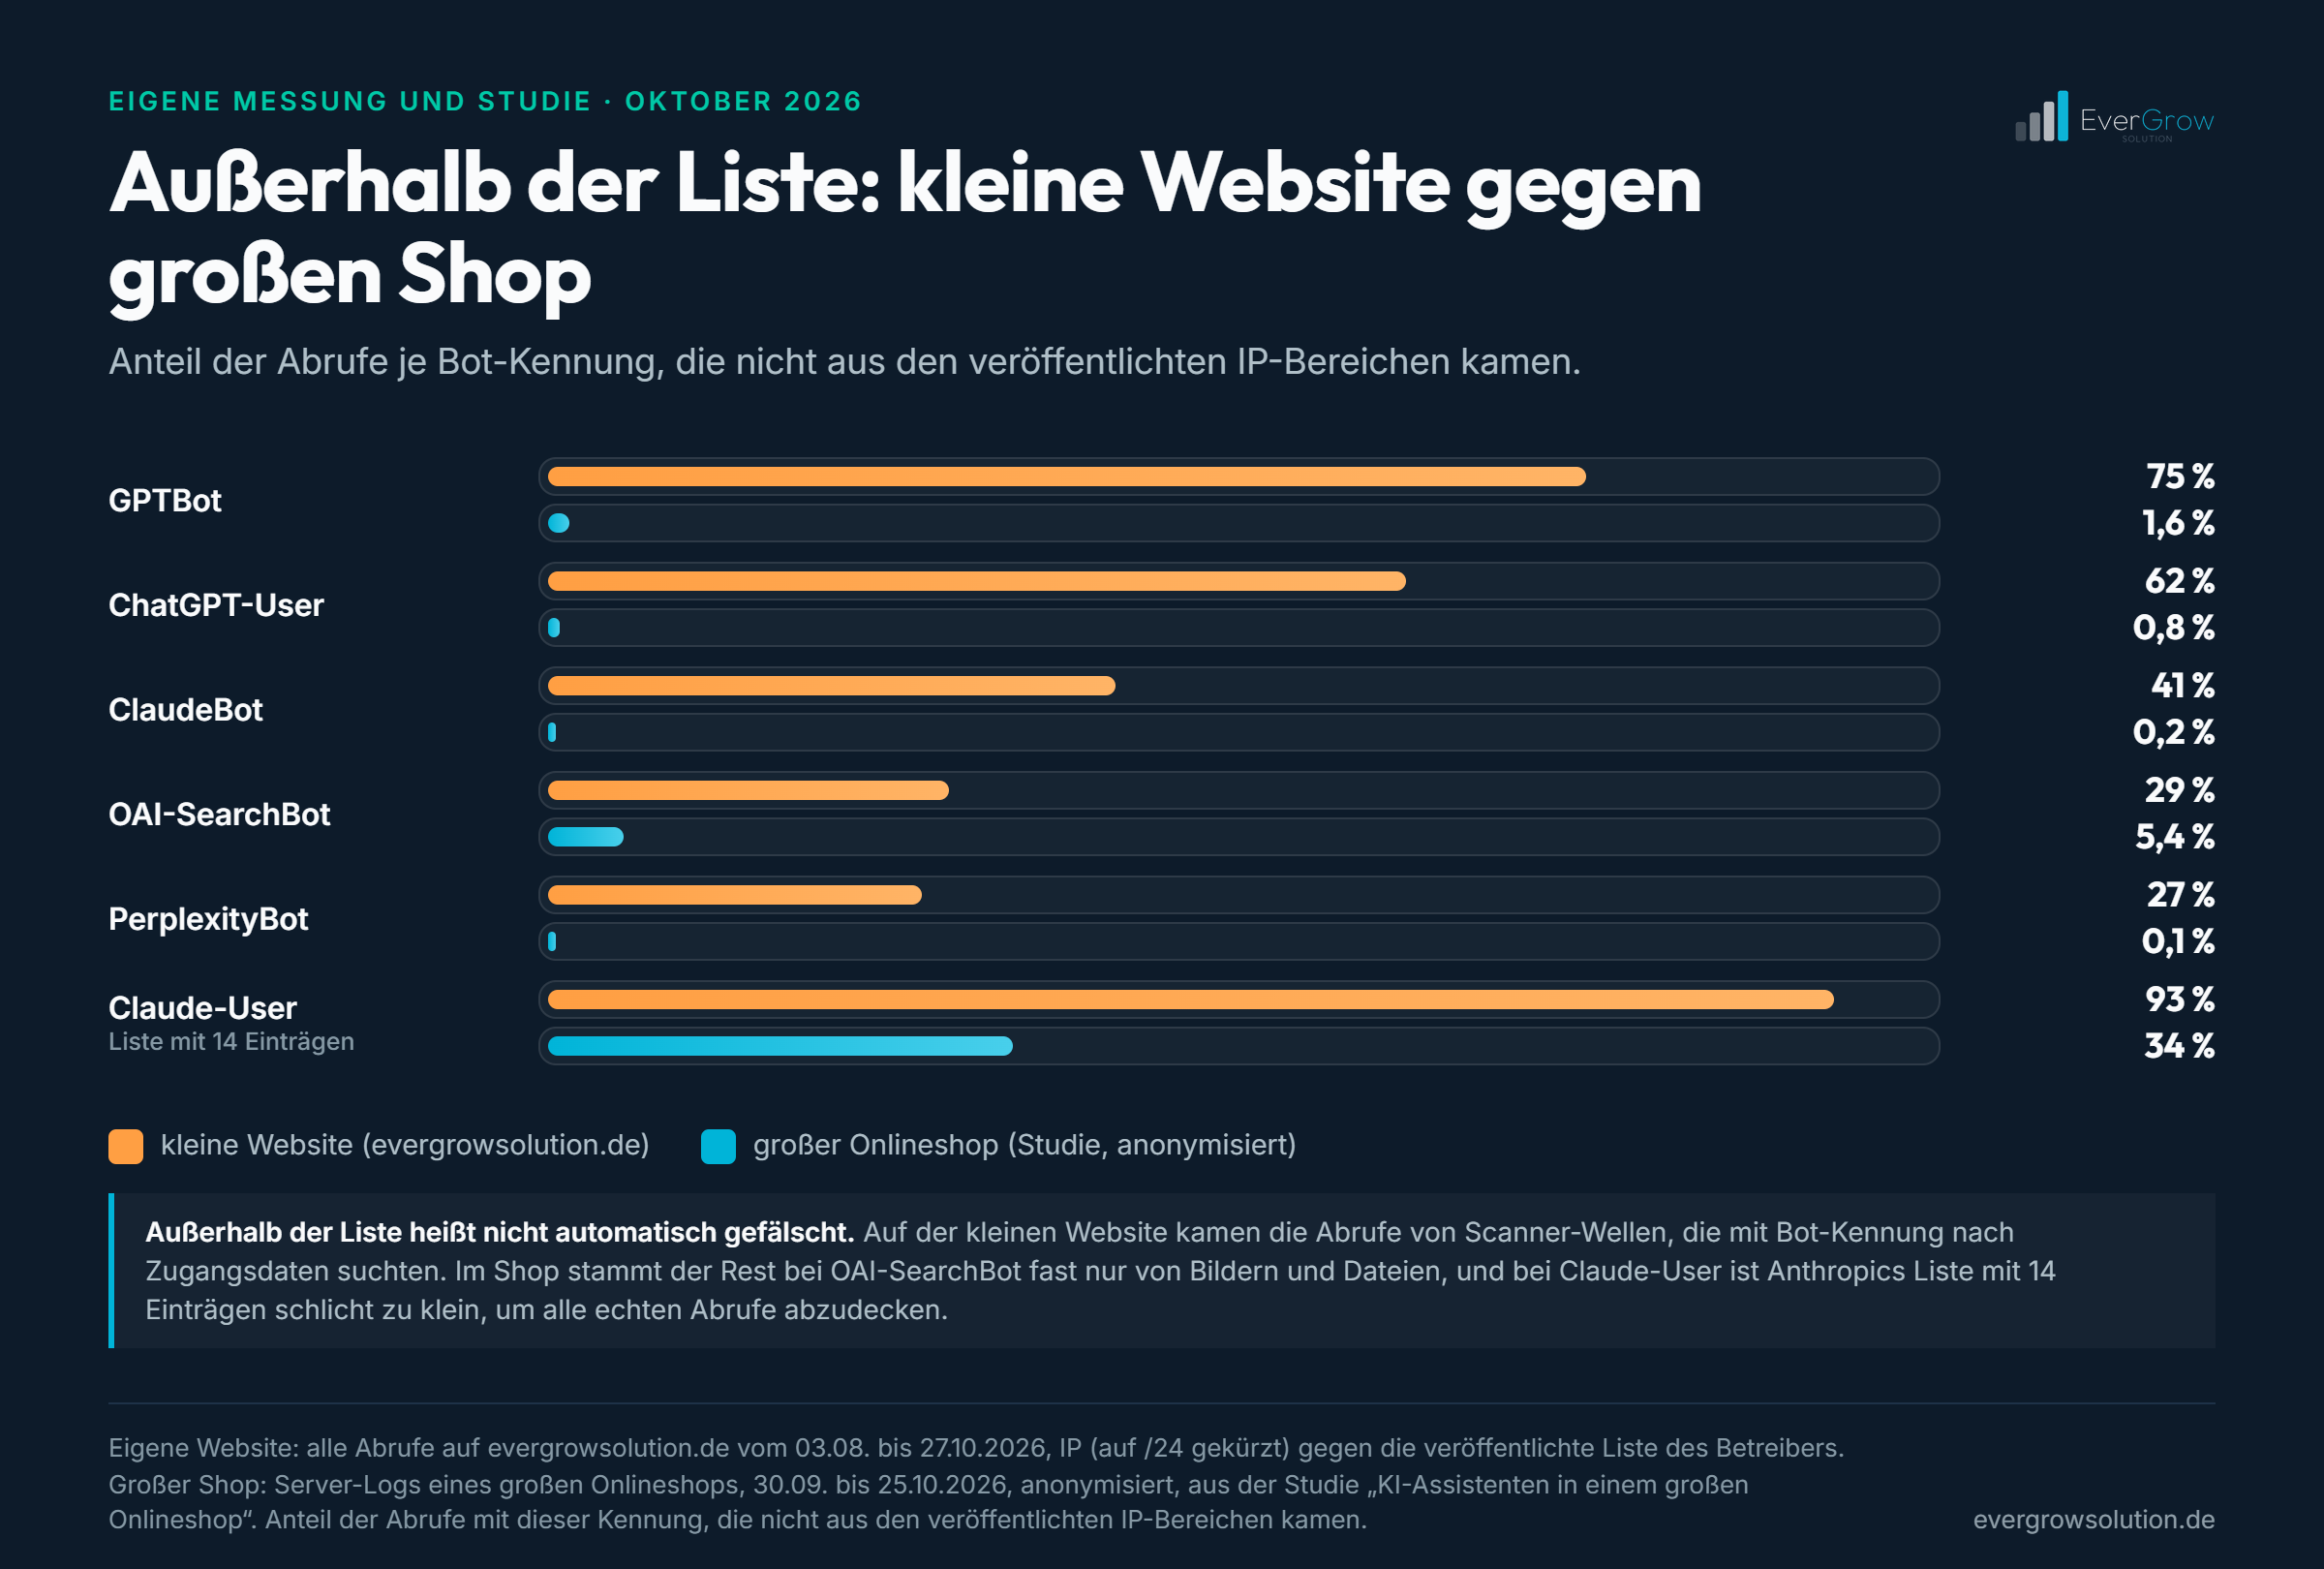
| Kennung | kleine Website | großer Onlineshop |
|---|---|---|
| GPTBot | 75 % | 1,6 % |
| ChatGPT-User | 62 % | 0,8 % |
| ClaudeBot | 41 % | 0,2 % |
| OAI-SearchBot | 29 % | 5,4 % |
| PerplexityBot | 27 % | 0,1 % |
| Claude-User | 93 % | 34 % |
Eigene Website 3. August bis 27. Oktober 2026 (IP auf /24 gekürzt, deshalb Untergrenze); großer Onlineshop 30. September bis 25. Oktober 2026, anonymisiert. Jeweils Anteil der Abrufe mit dieser Kennung, die nicht aus den veröffentlichten IP-Bereichen kamen.
Drei Dinge lese ich daraus. Erstens: Auf einer kleinen Website mit wenig echtem Bot-Verkehr fallen ein paar Scanner-Wellen sofort ins Gewicht; im Shop mit Millionen Bot-Abrufen gehen dieselben Scanner im Rauschen unter. Zweitens: Außerhalb der Liste heißt nicht automatisch gefälscht. Im Shop stammten die OAI-SearchBot-Abrufe außerhalb der Liste fast nur von Bildern und Dateien, und bei Claude-User ist Anthropics Liste mit 14 Einträgen zu klein, um alle echten Live-Abrufe abzudecken; ein Drittel „außerhalb“ sagt dort wenig. Drittens: Für Bots ohne veröffentlichte Liste bleibt nur die Netzprüfung. Amazon veröffentlicht inzwischen eine Liste für Amazonbot, Meta für meta-externalagent nicht; dort hilft nur der Abgleich mit dem Netz des Betreibers, im Shop kamen über 99,9 % der Meta-Abrufe aus dessen Netz.
Halten sich KI-Bots an robots.txt?
OpenAI, Anthropic, Google und Apple sagen für ihre Crawler zu, robots.txt zu beachten; Perplexity nennt robots.txt als Weg, den Umgang mit seinen Bots zu steuern. Bei Nutzerabrufen weichen OpenAI, Perplexity und Google davon ab, weil dort ein Mensch den Abruf auslöst. Das steht in den Dokus:
| Kennung | Aussage des Betreibers |
|---|---|
GPTBot, OAI-SearchBot | Über robots.txt steuerbar, jede Kennung unabhängig. Für die Suche nennt OpenAI rund 24 Stunden, bis eine Änderung wirkt. Quelle |
ChatGPT-User | „Because these actions are initiated by a user, robots.txt rules may not apply.“ Quelle |
ClaudeBot, Claude-SearchBot, Claude-User | Beachten robots.txt einschließlich Crawl-delay. CAPTCHAs umgehen sie laut Anthropic nicht. Quelle |
PerplexityBot | Perplexity nennt robots.txt als Weg, den Umgang mit seinen Bots zu steuern, und empfiehlt, PerplexityBot zuzulassen. Änderungen brauchen bis zu 24 Stunden. Quelle |
Perplexity-User | „Since a user requested the fetch, this fetcher generally ignores robots.txt rules.“ Quelle |
Googlebot und andere gängige Google-Crawler | Beachten robots.txt bei automatischen Crawls immer. Quelle |
Nutzerausgelöste Google-Abrufer | „Because the fetch was requested by a user, these fetchers generally ignore robots.txt rules.“ Quelle |
Applebot | Beachtet robots.txt bei allgemeinen Such-Crawls. Ohne eigene Applebot-Regel folgt er den Googlebot-Regeln. Crawl-delay beachtet er nicht. Quelle |
Ob sich ein Bot daran hält, zeigt nur dein Log: verifizierte Abrufe auf Pfade, die deine robots.txt für genau diese Kennung sperrt. Fremde Messungen sind schwer übertragbar. Laut einem Bericht von TollBit, einem Anbieter von Bezahlschranken für KI-Bots, erreichten im ersten Halbjahr 2026 rund 15 Prozent der identifizierten KI-Abrufer auf europäischen Websites aus seinem Bericht gesperrte URLs. Wie TollBit das gemessen hat, steht im SEJ-Bericht nicht (Search Engine Journal, 14.08.2026).
Und noch einmal: robots.txt ist eine Bitte, keine Zugangskontrolle. Was nicht abgerufen werden darf, gehört hinter einen Login. Welche Zeilen du für OpenAIs Bots setzt, steht im Ratgeber GPTBot, OAI-SearchBot, ChatGPT-User.
Was du in den Logs messen kannst
Sind die Abrufe verifiziert, werden die Zahlen aussagekräftig. Diese Kennzahlen lohnen sich, jeweils getrennt nach Betreiber und Zweck:
Verifizierte Abrufe je Zweck
Training, Suchindex und Nutzerabruf getrennt zählen, je Betreiber. Eine Summe „KI-Bots“ mischt Dinge, die nichts miteinander zu tun haben.
Anteil ohne Bestätigung
Wie viele Abrufe je Kennung nicht aus den Netzen des Betreibers kamen. Diese Zeilen gehören in eine eigene Spalte, nicht in die Bot-Statistik.
Statuscodes je Bot
200, Weiterleitungen, 404 und 410, 403, 429 und 5xx, getrennt nach Kennung und nur für verifizierte Abrufe. Ein Fehler, den nur ein Bot bekommt, hat meist eine Regel als Ursache.
Abdeckung wichtiger Seiten
Welche Seiten ein Bot im Zeitraum überhaupt abgerufen hat und welche nie. Bei Shops: Produkte, Kategorien, Filter-URLs.
Zeit bis zum ersten Abruf
Wie lange es dauert, bis ein Such-Bot eine neue Seite zum ersten Mal holt. Das zeigt, wie schnell neue Inhalte überhaupt in einen Index kommen können.
robots.txt-Abrufe
Wann ein Bot die Datei holt und ob er danach gesperrte Pfade meidet. OpenAI kann beim Abruf der robots.txt den Zusatz „robots.txt“ in den User-Agent schreiben.
Antwortgröße
Ob der Bot die Seite bekommt oder eine leere Hülle, eine Fehlerseite oder eine Abfrage zur Bot-Prüfung. Gleiche URL, auffällig kleine Antwort: genauer hinsehen.
Nutzerabrufe je Seite
Welche Seiten ChatGPT-User, Claude-User oder Perplexity-User abrufen. Das ist das Signal, das am nächsten an echter Nachfrage liegt.
Was 403 und 429 bei KI-Bots bedeuten
403 (Forbidden) heißt: Der Server hat die Anfrage verstanden und verweigert sie (RFC 9110). Bei KI-Bots kann das statt von deiner Anwendung auch von einer Bot-Regel im CDN, einer Firewall oder beim Hoster kommen. Bei Fälschungen ist das gewollt. Bekommt ein verifizierter OAI-SearchBot oder PerplexityBot ein 403, sieht der Suchindex deine Seite nicht, egal was in deiner robots.txt steht.
429 (Too Many Requests) heißt: zu viele Anfragen in zu kurzer Zeit (RFC 6585). Für Google ist das Verhalten dokumentiert: Bei 429 und 5xx crawlen Googles Crawler vorübergehend langsamer, und URLs, die dauerhaft Serverfehler liefern, fallen irgendwann aus dem Index. Google rät ausdrücklich davon ab, die Crawl-Rate mit 401 oder 403 zu begrenzen (Google, aktualisiert 04.02.2026). Wie GPTBot, ClaudeBot oder PerplexityBot auf 429 reagieren, beschreiben deren Bot-Seiten nicht. Anthropic unterstützt stattdessen Crawl-delay in der robots.txt. Applebot beachtet Crawl-delay laut Apple nicht, passt seine Geschwindigkeit aber an, wenn eine Website langsamer wird oder Fehler liefert.
Zähle 403 und 429 deshalb immer getrennt für verifizierte und nicht verifizierte Abrufe. Ein hoher 403-Anteil bei Fälschungen ist ein gutes Zeichen. Derselbe Anteil bei echten Suchbots ist eine Sperre, von der du vermutlich nichts weißt.
Nutzerabrufe als Nachfragesignal
ChatGPT-User, Claude-User, Perplexity-User und Googles nutzerausgelöste Abrufer haben eines gemeinsam: Sie rufen ab, weil gerade ein Mensch etwas gefragt hat. Das ist kein Klick und keine Personenzahl. Es ist aber das Signal in deinen Logs, das am nächsten an echter Nachfrage liegt, und es hängt an keinem Kennzeichen in der Adresse.
Wie nützlich das ist, hat der ChatGPT-utm-Ausfall im Oktober 2026 gezeigt. In den Server-Logs eines großen Onlinehändlers fielen die gekennzeichneten ChatGPT-Klicks vom 9. bis 12. Oktober um 73 Prozent gegenüber der Vorwoche, vom 13. bis 15. Oktober um 79 Prozent. Die ChatGPT-User-Abrufe, nur von bestätigten OpenAI-Adressen, lagen dagegen nur rund 20 Prozent darunter. Je 100 Abrufe kamen statt 34 nur noch 11 bzw. 9 gekennzeichnete Klicks an. Der größte Teil des Einbruchs war also fehlende Kennzeichnung, nicht fehlende Nachfrage. Methode und Grenzen stehen in der Studie zum ChatGPT-utm-Ausfall.
Drei Grenzen gehören dazu:
- Nicht jede Antwort löst einen Abruf aus. Antwortet ChatGPT aus OpenAIs eigenem Suchindex, gibt es keinen Live-Abruf durch ChatGPT-User. Null Nutzerabrufe heißt deshalb nicht automatisch, dass dein Zugang gesperrt ist.
- Ein Abruf ist kein Zitat. Er zeigt, dass deine Seite für eine Frage gelesen wurde, nicht, ob sie in der Antwort auftaucht.
- Die Grundmenge kann sich verschieben. Ändert ein Anbieter, wie oft er live nachlädt, ändern sich die Abrufe, ohne dass sich die Nachfrage ändert. Vergleiche deshalb eher kurze Zeiträume.
Welche Seiten Nutzerabrufe bekommen, ist trotzdem aufschlussreich: Produktseiten, Kategorien oder Ratgeber? Wie das in Shops aussieht, steht im Ratgeber Logfiles im Onlineshop.
Mehr Abrufe heißt nicht mehr Zitate
Eine verbreitete Fehldeutung in KI-Bot-Auswertungen: Viele Abrufe gelten als gutes Zeichen für die Sichtbarkeit. Logs zeigen aber nur, dass ein Bot eine Seite geholt hat. Trainings-Crawler haben mit Antworten gar nichts zu tun, und auch ein Suchbot-Abruf garantiert keine Nennung.
Cloudflare hat für sein Netz gezählt, wie viele Seiten ein Anbieter abruft, bis er einen Besucher auf eine Website weiterleitet. Im Juli 2025 waren das bei Anthropic rund 38.066 Abrufe je Weiterleitung, bei OpenAI rund 1.091, bei Perplexity rund 195 und bei Google rund 5 (Cloudflare, 29.08.2025). Abrufe und Nutzen liegen also weit auseinander, und zwar je nach Anbieter sehr unterschiedlich weit.
Was Logs wirklich beantworten, ist die Vorfrage: Kommt der Suchbot an, bekommt er eine vollwertige Seite, und welche Seiten holt er nie? Ob ChatGPT, Perplexity oder Claude dich dann nennen, misst du mit einer festen Liste von Fragen. Wie das geht, steht im Ratgeber KI-Sichtbarkeit messen. Was eine Seite für ChatGPT zitierfähig macht, erklärt der Ratgeber ChatGPT-SEO.
CDN und Firewall: wenn der Bot nie beim Server ankommt
Läuft deine Website hinter einem CDN, sieht dein Server nur einen Teil der Abrufe. Was das CDN aus dem Cache beantwortet, landet nicht im Server-Log. Was eine Bot-Regel oder Firewall am CDN abweist, ebenfalls nicht. Ein KI-Bot, der in deinem Server-Log fehlt, kann also gesperrt sein, ohne dass du es dort je siehst. Dann brauchst du die Logs oder Sicherheitsereignisse des CDNs.
OpenAI und Perplexity empfehlen ausdrücklich, Anfragen aus ihren veröffentlichten IP-Bereichen durchzulassen. Welche Schalter bei Cloudflare zusammenspielen und wie du die tatsächlich ausgelieferte robots.txt prüfst, steht im Ratgeber GPTBot, OAI-SearchBot, ChatGPT-User.
Quellen und Stand
Stand: 25. Oktober 2026. Alle Betreiber-Seiten und IP-Listen an diesem Tag abgerufen; bei den Listen steht der Stand aus der Datei selbst.
- Google: Anfragen von Google-Crawlern prüfen (aktualisiert 20.03.2026), gängige Crawler und Google-Extended (15.10.2026), nutzerausgelöste Abrufer (19.08.2026), Überblick über Googles Crawler (12.06.2026), HTTP-Statuscodes (04.02.2026), KI-Funktionen und deine Website (10.12.2025), Search-Console-Hilfe Bericht „Crawling-Statistik“ (ohne Datum). IP-Listen: common-crawlers.json, special-crawlers.json, user-triggered-fetchers.json, user-triggered-fetchers-google.json, user-triggered-agents.json (alle Listenstand 23.10.2026).
- OpenAI: Overview of OpenAI Crawlers (ohne Datum). IP-Listen: openai.com/gptbot.json (22.09.2026), openai.com/searchbot.json (02.01.2026), openai.com/chatgpt-user.json (20.10.2026), openai.com/adsbot.json (12.05.2026).
- Anthropic: Does Anthropic crawl data from the web … (07.04.2026). IP-Liste: claude.com/crawling/bots.json (20.10.2026).
- Perplexity: Perplexity Crawlers (ohne Datum). IP-Listen: www.perplexity.com/perplexitybot.json (07.02.2025), www.perplexity.com/perplexity-user.json (17.10.2025).
- Apple: About Applebot (04.09.2026). IP-Liste: search.developer.apple.com/applebot.json (15.09.2026).
- Microsoft: How to Verify that Bingbot is Bingbot (31.08.2012), Verify Bingbot. IP-Liste: www.bing.com/toolbox/bingbot.json (03.01.2024).
- Cloudflare: The crawl-to-click gap (29.08.2025), Web Bot Auth (aktualisiert 08.10.2026).
- Search Engine Journal: Duane Forrester, 81.8% Of My 'AI Assistant' Traffic Was Fake. The Googlebot Number Was Worse (25.06.2026); Matt G. Southern, OpenAI Says Robots.txt May Not Apply To ChatGPT's Fetch Bot (14.08.2026, TollBit-Zahlen).
- IETF: RFC 9110, Statuscode 403, RFC 6585, Statuscode 429.
- Eigene Zahlen: Messung gefälschter Kennungen auf evergrowsolution.de, 03.08.–14.10.2026, zuerst veröffentlicht im Ratgeber Logfile-Analyse für SEO; ChatGPT-User-Abrufe aus der Studie zum ChatGPT-utm-Ausfall (16.10.2026).